從 AI 火焰圖分析到經驗證的修復:用 OpenResty XRay 驅動 Coding Agent 效能最佳化閉環

效能最佳化的核心訴求向來明確:從複雜的 CPU 取樣資料中,得出清晰的診斷結論與可驗證的修復方案。 藉助 OpenResty XRay AI Assistant Skill,Claude Code、Codex、Cursor 等 AI coding agent 能夠直接對接 OpenResty XRay——自動識別目標程序、觸發分析器,基於真實執行時取樣完成火焰圖的 AI 分析,並將熱點精準對映至具體的原始檔與行號。
對於已經在目標機器上部署了 OpenResty XRay 的團隊而言,這一組合的真正價值在於:它補齊了 coding agent 缺失的執行時上下文。 AI 不再依賴對靜態程式碼的空泛猜測,而是基於動態追蹤採集到的真實取樣來定位瓶頸、提案重構。本文以一個貼近生產的 Checkout 邊緣服務為例,演示 coding agent 如何在 OpenResty XRay 真實資料的驅動下,透過三輪小步重構,將服務吞吐量從約 336 RPS 逐步提升至接近 30,000 RPS。
您的 coding agent 缺的不是智力,是執行時視野
Claude Code、Codex、Cursor 這類 coding agent 已經非常擅長閱讀和重構程式碼。但當您讓它“最佳化一下這個服務的效能”時,它的視野被侷限在靜態原始碼檔案裡:它只能基於通用經驗猜測熱點在哪,而猜出來的往往是無關痛癢的微最佳化。
這個盲區在 vibe coding 場景下被進一步放大:當應用的大部分程式碼由 coding agent 直接生成、開發者主要負責描述需求和驗收結果時,類似本文後面演示的“重複序列化”“重複掃描”這類效能反模式,很容易在一輪輪快速生成中悄悄累積——程式碼功能正確、測試也能透過,跑起來卻遠低於應有的效能水位,而生成這些程式碼的 agent 自己無從察覺。
對親手查過效能問題的工程師來說,另一半痛點同樣熟悉:拿到一張 CPU 火焰圖往往只要幾秒鐘,真正耗費時間的是拿到圖之後的分析與驗證:
- 這個熱點對應哪一段業務程式碼?
- 它是業務邏輯寫得有問題、LuaJIT 沒 JIT 成功、C 庫開銷,還是單純的網路 IO?
- 下一步應該啟動 OpenResty XRay 的 Lua 分析器還是 native C 分析器?
- 修改程式碼後,怎麼快速證明熱點真的消失了,而不是轉移到了別處?
傳統排查時,工程師需要在終端、監控平臺、分析器頁面和程式碼編輯器之間來回切換,靠人腦把火焰圖上的棧幀和編輯器裡的程式碼逐行對齊。
OpenResty XRay AI Assistant Skill 把這兩個斷開的世界接通了:真實取樣資料經由 Skill 流入 coding agent 的上下文,“解釋火焰圖 → 修改程式碼 → 回歸驗證”收攏在同一個終端會話裡完成,每個環節各司其職:
[ 目標機器 ]
  └─ OpenResty XRay Agent:非侵入式動態追蹤取樣
        │  真實取樣報告 / 火焰圖
        ▼
[ OpenResty XRay AI Assistant Skill ](MCP 橋樑)
        │  結構化堆疊 + 原始碼行號對映
        ▼
[ coding agent ](Claude Code / Codex / Cursor)
  └─ 解讀熱點 → 提出最小修改方案 → 在同一負載下複測驗證
[ 工程師 ]
  └─ 出題、確認業務契約、審批狀態變更操作
OpenResty XRay AI Assistant Skill 是甚麼
我們在今年七月推出了內建於 OpenResty XRay 控制檯的 AI 助手(Beta)——方便大家在 Web 頁面裡直接解讀報告和火焰圖。這次的 OpenResty XRay AI Assistant Skill 則是同一能力的另一個出口:把它接入您日常寫程式碼用的 coding agent。控制檯 AI 助手適合“在網頁看報告時順手問”,Skill 則適合“在編輯器和終端裡完成整個最佳化閉環”——分析資料和原始碼終於出現在了同一個上下文裡。
前提:目標機器上必須已安裝 OpenResty XRay Agent
這裡先明確本文的適用範圍:OpenResty XRay AI Assistant Skill 不是獨立工具,它是 OpenResty XRay 的接入方式之一。 它的全部價值都建立在 OpenResty XRay 對目標應用的非侵入式動態追蹤之上——目標應用無需修改程式碼、無需重啟,但採集資料的 OpenResty XRay Agent 守護程序必須先在目標機器上部署好。沒有 Agent 在後臺採集,Skill 就沒有任何資料可讀,也無法建立分析任務。
換句話說,本文寫給的是“機器上已有 OpenResty XRay、編輯器裡已有 coding agent”的開發者。如果您還不是 OpenResty XRay 使用者,可以先申請試用,完成 Agent 安裝後再照著本文實操。
用自然語言描述診斷目標
安裝 Skill 後,您和 coding agent 的對話就可以直接以 OpenResty XRay 的真實資料為依據。工程師負責出題:
檢查 OpenResty XRay Agent 973,確認當前 Checkout Edge 的 OpenResty worker、負載和可用分析器。

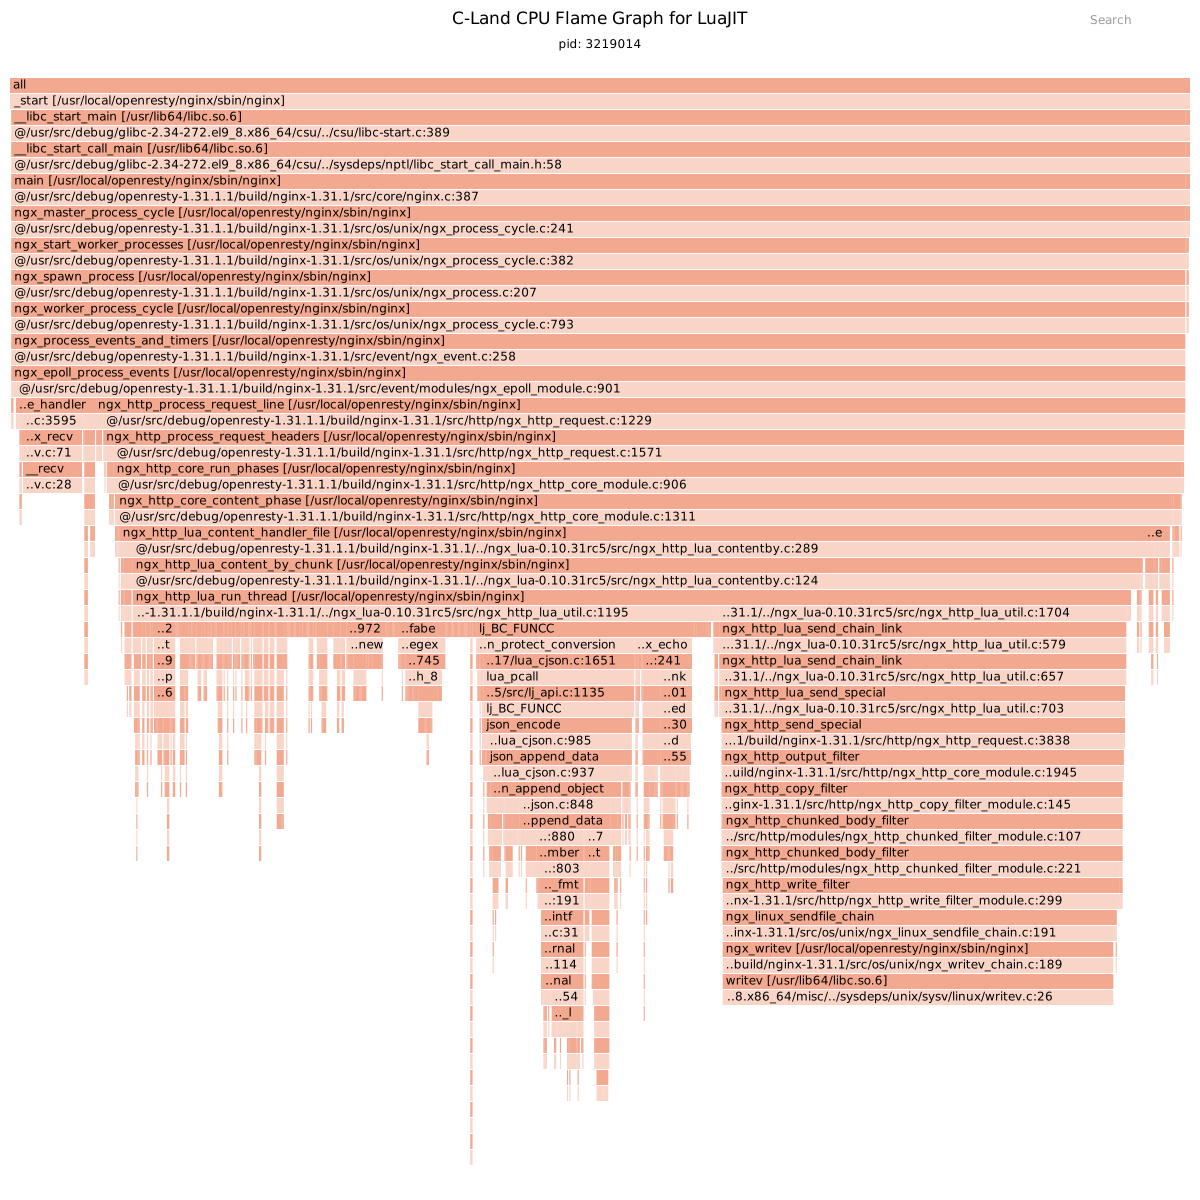
在相同 wrk 負載下,對剛確認的 worker 執行短時 lj-lua-on-cpu,找出最熱的原始碼呼叫鏈。

讀取剛完成的報告,把熱點對映到 audit.lua,並給出只改變一個假設的最小修複方案。
coding agent 會經由 Skill 把這些請求轉化為面向 OpenResty XRay 的診斷動作,並在返回結果時保留完整的上下文證據:
- 實際目標機器和 PID/程序;
- Worker / Master 程序關係;
- 分析器名稱;
- 樣本數量和取樣時長;
- 原始檔、行號和完整呼叫鏈;
- LuaJIT、OpenResty、C 庫等跨層堆疊資訊。
狀態變更的二次確認:控制權在工程師手中
對於建立分析任務這類會改變 OpenResty XRay 狀態的操作,系統會彈出互動式二次確認。Skill 在提交任務前會返回如下確認請求:
Confirmation required before changing XRay state.

Create a new jobs resource.

choices: approve | reject
工程師明確回覆 approve 後,coding agent 才會繼續提交任務;回覆 reject 則拒絕當前操作。也就是說,coding agent 不會在未經授權的情況下自行啟動分析任務;而讀取報告、對照程式碼和繼續追問,則可以在同一個對話上下文中連續完成。
演示案例:一個貼近生產的 Checkout 邊緣服務
為了演示這條工作流,我們構造了一個貼近實際專案的 Checkout Edge 服務,並在其中刻意植入了幾類真實系統中常見的效能反模式(後文會逐一揭開)。它不是隻有一個簡單的 Lua handler,而是包含了多個典型的邊緣業務階段:
請求
 ├─ context.lua   提取請求、租戶、賬號、Feature Flag
 ├─ catalog.lua   商品查詢、報價、折扣和推薦項
 ├─ risk.lua      User-Agent 風險規則和風控決策
 ├─ audit.lua     審計事件構造與 JSON 序列化
 └─ app.lua       編排請求流程並輸出響應
目錄結構如下:
demo/
├── nginx.conf
└── lua/
    ├── app.lua
    └── lib/
        ├── audit.lua
        ├── catalog.lua
        ├── context.lua
        └── risk.lua
為方便大家復現,示例使用了本地商品目錄和記憶體規則資料,不依賴外部資料庫;請求編排、審計、風控和序列化路徑則保留了生產系統應有的複雜度。
啟動服務與固定壓測負載
進入 demo 目錄後啟動 OpenResty:
cd /path/to/demo
mkdir -p logs
openresty -t -p "$PWD" -c nginx.conf
openresty -p "$PWD" -c nginx.conf -g 'daemon off;'
發個請求驗證服務是否正常:
curl -s \
  'http://127.0.0.1:18080/v1/checkout/quote?tenant=acme-eu&sku=edge-cache&quantity=2'
接著用固定的 wrk 命令產生測試負載。後續的每一個最佳化階段,我們都保持 URL、執行緒數和連線數完全一致:
wrk -t2 -c50 -d60s --latency \
  'http://127.0.0.1:18080/v1/checkout/quote?tenant=acme-eu&sku=edge-cache&quantity=2'
說明:本文對照表中的吞吐資料均來自相同 URL、執行緒數和連線數的 wrk 壓測;為配合線上分析任務,各階段執行時長略有不同,資料旨在展示最佳化方向與數量級趨勢。OpenResty XRay 的火焰圖取樣則使用獨立的長時負載,避免確認和分析耗時影響 wrk 的對照資料。兩組實驗各答各的問題:取樣回答“CPU 花在哪裡”,壓測回答“固定負載下服務表現如何”。更嚴謹的基準測試還應固定壓測時長、CPU 綁核、Worker 數量並重復多輪。
基線排查:coding agent 定位到 99.3% 的 CPU 在重複序列化審計物件
基線版本的程式碼會將完整的請求上下文、報價、風控結果和除錯追蹤封裝進一個深層物件,然後為了模擬多個審計 Sink,對其重複進行了 JSON 編碼——這是我們植入的第一個反模式:
-- 基線版本:demo/lua/lib/audit.lua
local payload
for _ = 1, 120 do
    payload = cjson.encode(record)
end
return payload
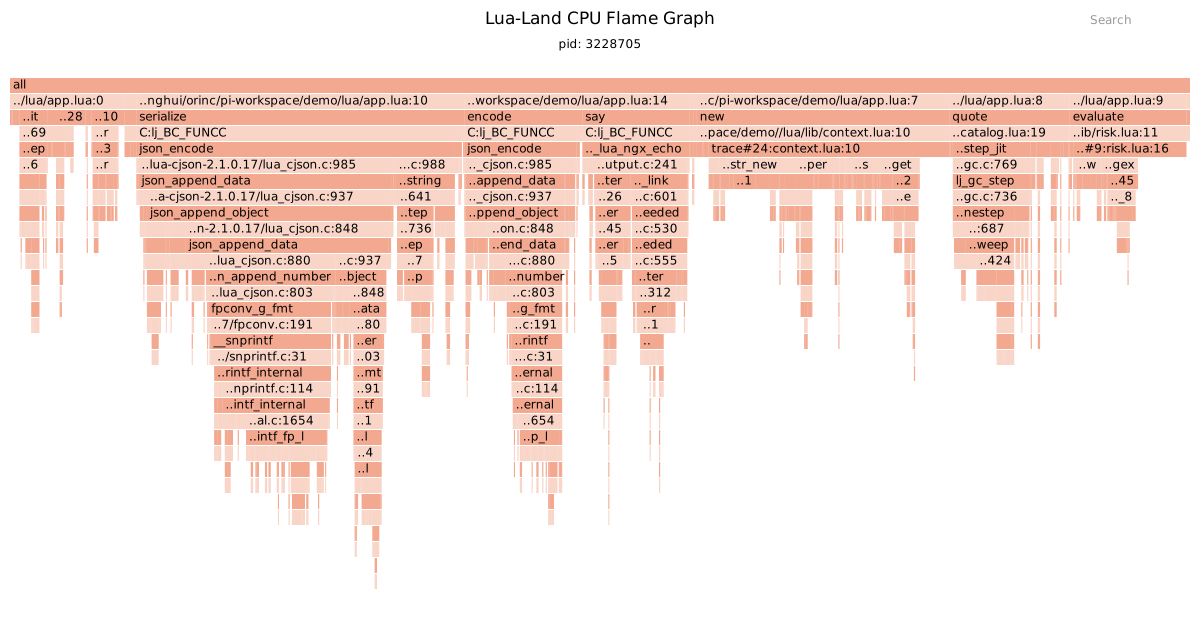
從表面上看,HTTP 請求沒有報錯,響應也能正常返回。排查從前文那三條自然語言指令開始:工程師不必先盲目猜程式碼,而是讓 coding agent 直接檢查正在執行的 Worker,並在 approve 確認後啟動 lj-lua-on-cpu 分析器採集 Lua CPU 火焰圖。
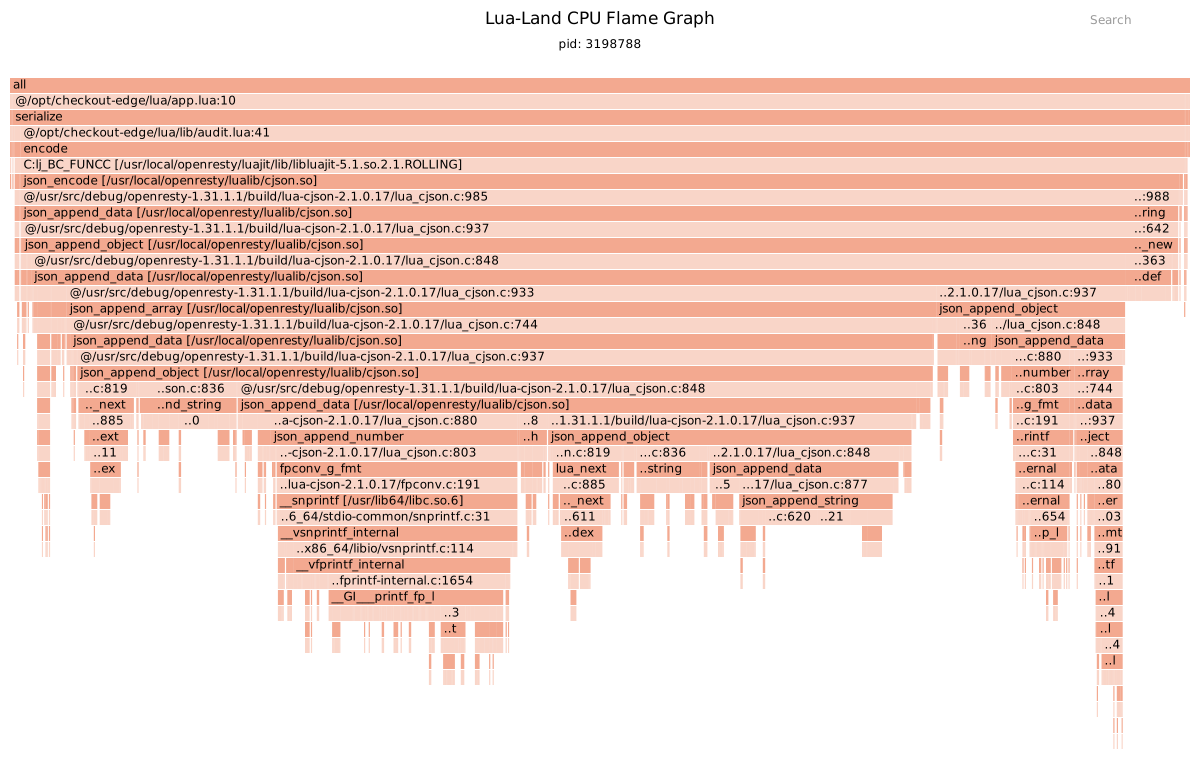
本次演示採集到的基線報告:
OpenResty XRay 在約 3.5 秒內採集了 1,000 個樣本,CPU 熱點非常集中:
| 熱點 | Inclusive CPU |
|---|---|
app.lua:10 呼叫的 audit.serialize | 99.3% |
audit.lua:41 的 encode | 98.6% |
cjson 的 json_encode | 98.2% |
lua_cjson.c:985 的 JSON 遍歷路徑 | 94.1% |
coding agent 讀取報告後,將這條呼叫鏈還原為:
app.lua
  → audit.serialize
    → cjson.encode
      → cjson 遞迴遍歷審計物件和陣列
並把熱點準確對映到了具體的原始檔和行號——audit.lua 第 41 行的 encode 呼叫。和直接把程式碼或截圖扔給通用聊天機器人不同,coding agent 此刻給出的結論不是來自對程式碼的靜態猜測,而是直接讀取當前 Worker 的 OpenResty XRay 真實取樣,取樣數量、程序和原始碼行號都在證據鏈裡。
當然,火焰圖能證明 CPU 樣本集中在哪,但並不能替工程師決定審計協議裡的哪些欄位是必需的。這是第一個必須由人來把關的決策點。
第一刀:精簡審計資料結構(336 → 4,457 RPS)
coding agent 的提案與工程師的契約確認
coding agent 結合火焰圖和 audit.lua 原始碼給出的判斷是:審計物件太大——完整的請求上下文、推薦商品列表和除錯追蹤都被塞進了每一條審計日誌,而審計下游真正需要的只是穩定的業務事實(請求 ID、租戶、使用者、報價金額、幣種、區域和風控結果)。
哪些欄位能刪,屬於業務契約,由工程師確認。確認後的第一步修改只縮小物件體積,暫不修改序列化次數——遵循“每次只驗證一個假設”的原則:
-- Stage 1:改為 Allowlist DTO
local record = {
    schema = "checkout.audit.v2",
    event = "quote_generated",
    request_id = context.request.id,
    tenant = context.account.tenant,
    user_id = context.account.user_id,
    region = quote.region,
    currency = quote.currency,
    total = quote.total,
    risk = {
        score = risk.score,
        decision = risk.decision,
    },
    flags = {
        checkout_v2 = context.flags.checkout_v2,
        risk_v3 = context.flags.risk_v3,
    },
    emitted_at = ngx.now(),
}
同一負載複測,coding agent 解讀新火焰圖
審計物件從原本包含除錯追蹤的約 5.8 KB 縮小到了約 281 位元組。在相同的 wrk 引數下重新壓測,服務吞吐量從 336 RPS / p99 182.86 ms 直接提升到了 4,457 RPS / p99 14.13 ms。
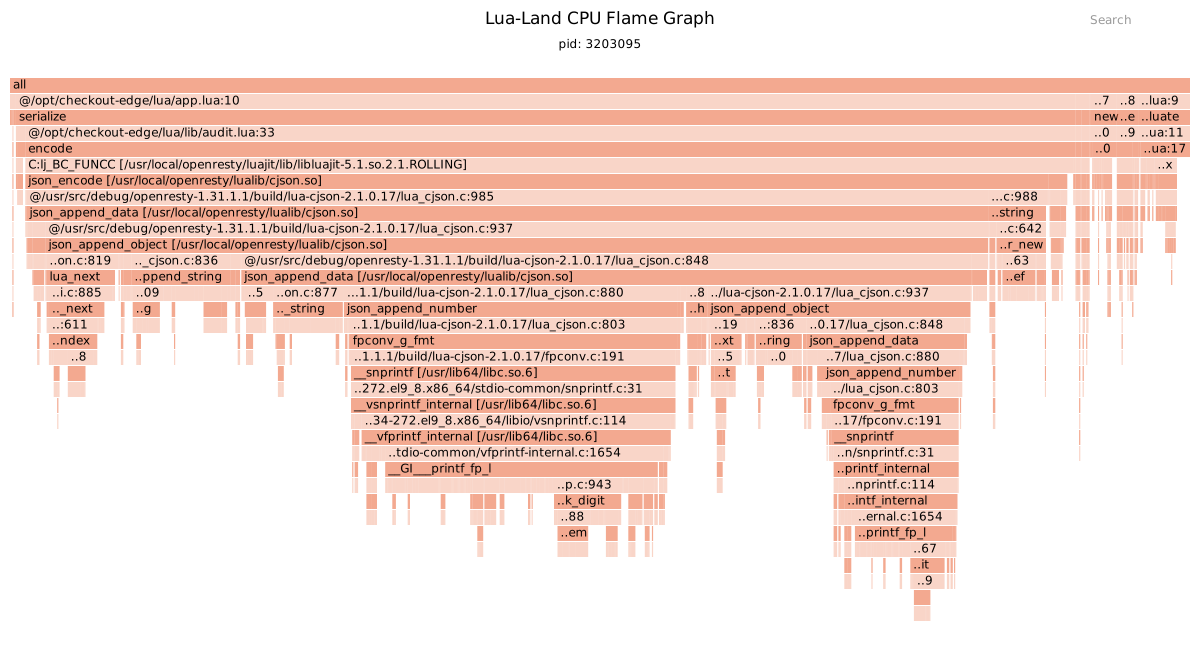
改完後,再讓 coding agent 拉取一次 OpenResty XRay 的 Lua 火焰圖:
火焰圖顯示,serialize 依然佔據了 89.8% inclusive CPU,但內部的熱點細節發生了變化:
json_append_number:28.3%;fpconv_g_fmt:27.8%;- libc 浮點數格式化路徑:23.1%。
coding agent 據此給出的結論很明確:縮小資料結構帶來了數量級的效能提升,但“重複序列化”依然是結構性的浪費——“改動是否有效”被明確推進為了“下一步該改甚麼”。關於 JSON 編碼為何頻繁成為這類服務的效能瓶頸,可參考我們此前的分析:《當 JSON 成為 OpenResty 服務的隱形瓶頸》。
第二刀:同一份資料只編碼一次(→ 26,028 RPS)
既然所有的審計 Sink 消費的都是同一份資料,完全沒必要為每個 Sink 都重新遍歷一遍 Lua table。第二次修改只保留一次編碼:
-- Stage 2:保留 DTO,只做一次 JSON 編碼
function _M.serialize(context, quote, risk)
    local record = build_audit_record(context, quote, risk)
    return cjson.encode(record)
end
這一步並沒有更換 JSON 庫,只是刪除了 119 次完全重複的無效工作。
Stage 2 重新壓測,吞吐量直接飆升到 26,028 RPS / p99 13.96 ms。此時再讓 coding agent 讀取新一輪 Lua 火焰圖,審計序列化開銷已經不再霸屏:
OpenResty XRay 的取樣暴露出了隱藏在下一層的業務路徑:
- 請求上下文建立:14.4% inclusive CPU;
- 風控規則呼叫鏈佔約 36.7% inclusive,其中
pcre2_match_8子路徑佔約 9.4%; - 商品報價與 LuaJIT GC 路徑佔約 6.6%。
效能調優裡經常遇到這種現象:並不是第二個熱點突然出現了,而是當第一個主要瓶頸被剷除後,次要瓶頸才有機會顯現出來。
切換 Lua 與 C 雙視角:writev 看起來很寬,但它不是業務瓶頸
從剛剛的 OpenResty XRay Lua 火焰圖來看,風控模組值得進一步分析,但裡面混合了 Lua 迴圈、字串處理、Nginx 正則 FFI 和 native matcher。coding agent 基於報告中實際出現的 Native 路徑,建議切換視角:對同一個 Stage 2 Worker 再啟動支援 LuaJIT 的 OpenResty XRay C on-CPU 分析器——而不是機械地照搬固定的排查清單:
C 層面的火焰圖直觀展現了跨層分析的價值:
pcre2_match_8只有 3.1% inclusive CPU;writev佔到了 33.0% inclusive,其 self weight 為 330 / 1,000 = 33.0%——分母是這張火焰圖的 total weight,而不是端到端請求數;json_append_object約佔 10.4%。
這裡 coding agent 給出了一條關鍵提示:writev 主要是響應資料寫出和網路傳輸層的開銷,並不是 Checkout 風控業務邏輯的根因。不能僅僅因為它在 C 火焰圖裡看著很寬,就貿然去修改業務程式碼——響應體積、壓測客戶端和網路瓶頸應該單獨去評估。
這正是 OpenResty XRay 結合 Lua / C 雙視角分析的優勢所在:
- Lua 火焰圖幫助我們準確定位業務程式碼和呼叫鏈;
- C 火焰圖幫助我們確認 Native 底層的真實執行成本;
- 兩張圖結合,既避免把網路傳輸開銷誤判為業務瓶頸,也不會把 Lua 側的重複邏輯一股腦歸咎於 PCRE。
第三刀:消除等價的 12 倍重複掃描(→ 29,968 RPS)
coding agent 定位風控反模式
coding agent 順著 Lua 火焰圖裡的風控呼叫鏈讀取 risk.lua 原始碼,發現基線的風控程式碼對 8 個 User-Agent 模式重複掃描了 12 遍——這是我們植入的第二個反模式:
for _ = 1, 12 do
    for i = 1, #suspicious_agents do
        local from = ngx.re.find(agent, suspicious_agents[i], "ijo")
        if from then
            score = score + 1
        end
    end
end
這裡不能直接簡單地把外層迴圈刪掉,因為基線邏輯裡每匹配一條規則就會累積 12 分——風險分值屬於業務契約的一部分。這又是一個由工程師把關的決策點:分值語義必須保持不變。
保持分值邏輯,精簡掃描次數
Stage 3 的修改方案:將穩定的正則選項提至模組級別,確保每條規則對每個請求只執行一次,同時保留原有的 12 分權重:
-- Stage 3
local RULE_OPTIONS = "ijo"

for i = 1, #suspicious_agents do
    local pattern = suspicious_agents[i]
    local from = ngx.re.find(agent, pattern, RULE_OPTIONS)
    if from then
        -- 保持既有的風險分值契約
        score = score + 12
        hits[pattern] = true
    end
end
這裡的“等價”有明確前提:agent、規則陣列和規則選項在一次請求中不變;ngx.re.find 沒有被業務程式碼替換成帶副作用的函式;hits[pattern] = true 是冪等寫入;迴圈中沒有依賴中間狀態的其他邏輯。在這些前提下,基線中“每條命中規則加 1 分、重複 12 遍”才等價於最終版本中“每條命中規則一次性加 12 分”。如果正式專案的風控規則會修改上下文、依賴計數順序或存在其他副作用,就不能直接套用這個變換,必須為決策結果和 reason-code 增加回歸用例。
這次修改實現了:
- 保持規則集合、匹配選項、風控決策和審計結果完全不變;
- 刪除了 12 倍的等價重複掃描,大幅減少了 Lua 控制流、字串處理和正則 FFI 的呼叫次數;
- 使用
ngx.re的o選項(once-compilation),複用編譯後的正則模式。
如果您懷疑自己服務的瓶頸真的出在某條正則本身,可以按《Nginx 正則效能:用動態追蹤定位最慢的正則模式》中的方法單獨定位到具體的正則模式。
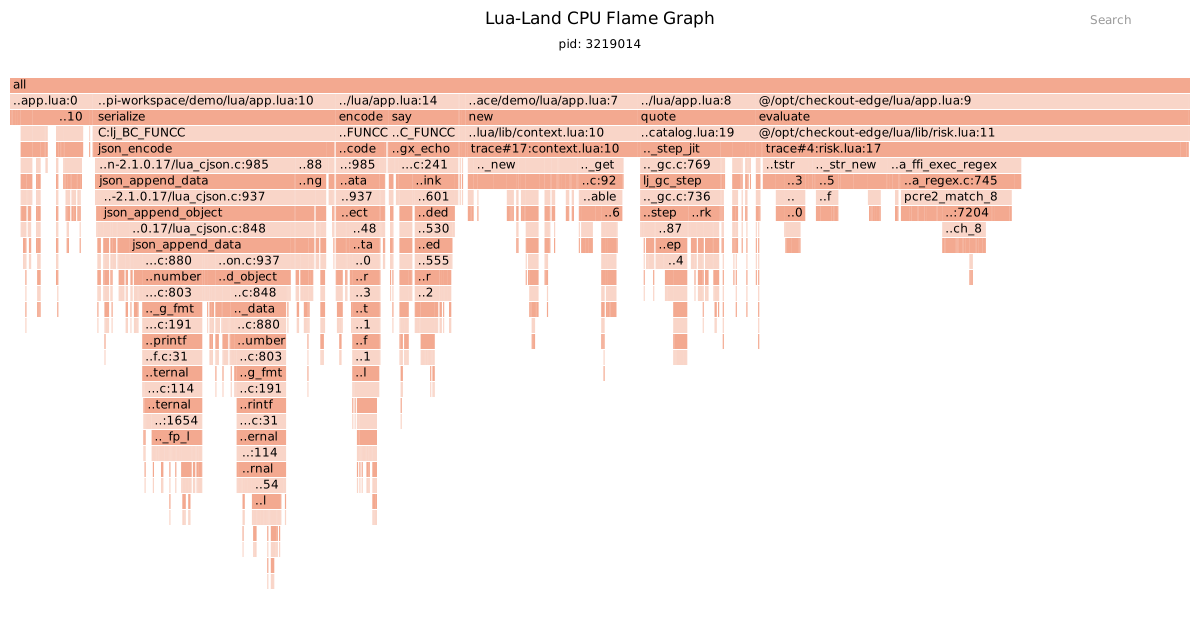
完成修改後,讓 coding agent 拉取最終的 OpenResty XRay 報告:
此時應用內的 CPU 熱點分佈已重新洗牌:
- JSON 響應序列化:27.8%;
- 請求上下文建立:21.4%;
- 商品報價路徑:10.2%(其中 LuaJIT GC 約佔 6.6%);
- 風險評估模組開銷已降至 9.9%。
到了這一步,繼續最佳化風控正則的邊際收益已經不高了。下一輪最佳化如果繼續推進,應該優先評估響應 Schema、上下文物件分配以及商品目錄的資料結構——而這個決策本身,依然來自 OpenResty XRay 的取樣資料,而不是 coding agent 對程式碼的憑空想象。
三輪最佳化的資料對比與方法邊界
| 版本 | 主要修改內容 | RPS | p99 延遲 | OpenResty XRay 觀察到的熱點 |
|---|---|---|---|---|
| 複雜基線 | 完整審計物件,重複編碼 120 次 | 336 | 182.86 ms | audit.serialize 佔 99.3% |
| Stage 1 | 審計物件改為 Allowlist DTO | 4,457 | 14.13 ms | serialize 降至 89.8%,浮點格式化顯現 |
| Stage 2 | 同一份 DTO 只進行 1 次 JSON 編碼 | 26,028 | 13.96 ms | 上下文建立、風控與目錄路徑顯現 |
| Stage 3 | 風控規則單次執行,複用正則編譯結果 | 29,968 | 2.97 ms | 風險評估開銷降至 9.9% |
再次強調:本文示例中的壓測是為了配合線上分析任務,各階段執行時長略有不同,表格資料旨在展示最佳化方向與數量級趨勢。實際線上服務變更前,建議使用固定時長壓測與完整回歸測試進行驗證。
同時,我們也需要清醒地認識到這套工作流的邊界:
- 業務決策由工程師把關。 審計欄位能不能刪、風險分值契約該怎麼定義,coding agent 只能基於程式碼和取樣提出假設,最終確認依然取決於工程師對業務協議的理解與測試驗證。
- coding agent 給出的是有據可查的推論,而非絕對真理。 每一項最佳化建議,工程師都應該回到 OpenResty XRay 的原始報告中進行核對——這也正是 OpenResty XRay AI Assistant Skill 在返回結果時始終附帶報告連結和樣本數量的原因。
- 它高度依賴已部署 OpenResty XRay Agent 的環境。 如果沒有 Agent 在後臺實時採集資料,這套自動化排查迴圈就無法運轉。
- 本文只驗證了兩個分析器。 實際執行並驗證過的是
lj-lua-on-cpu和lj-c-on-cpu。在本次目標機器的能力清單中還能看到更多方向——Lua off-CPU(lj-lua-off-cpu)、記憶體與 GC 相關診斷(lj-err-mem、lj-lua-newgco-size、lj-lua-tab-resize、lj-free-stats)、LuaJIT 執行時檢查(collect-luajit-ffnames、lj-func-events、lj-jit-state)等——但它們不等於已在本文實驗中執行過。具體分析器是否可用,還取決於目標執行時、Agent 版本、作業系統依賴、許可權和當前程序是否被正確發現;也不能把 on-CPU 結果當成 off-CPU、記憶體或 GC 結論。 - coding agent 側只驗證了當前 Skill。 Claude Code、Codex、Cursor 等 MCP 相容客戶端的接入方式見官方文件,但本文不能替代對各客戶端版本的逐一相容性測試。此外,短取樣、目標離線、負載結束或樣本不足,都會使報告無法支撐強結論。
開啟 OpenResty XRay AI Assistant Skill 體驗
如果您的團隊已經在日常開發中使用 Claude Code、Codex、Cursor 等支援 MCP 的 AI coding agent,並且目標機器上已經安裝了 OpenResty XRay,可以隨時登入 OpenResty XRay Web 控制檯,在 MCP Server & Agent Skill 入口獲取連線配置與安裝指南。
配置完成後,無論是在開發、測試階段還是線上排障,都可以直接在 coding agent 裡用自然語言進行互動:
- “哪個 OpenResty worker 正在消耗最多的 CPU?”
- “拉一份 Lua 火焰圖,幫我確認這究竟是不是業務程式碼熱點。”
- “如果 Lua 側開銷不明顯,再用 C 分析器查一下 Native 層的成本。”
- “把 OpenResty XRay 報告裡的熱點直接對映到原始碼,並給出改動最小、易於回滾的修復建議。”
對於以 vibe coding 方式快速構建應用的團隊,這條閉環的意義還要更進一步。我們在演示裡埋下的兩個反模式——重複序列化和重複掃描——正是 AI 生成程式碼最容易累積的那類看不見的效能債:功能正確、測試全綠,效能卻遠低於應有水位。當寫程式碼的和驗證效能的是同一個 coding agent 時,它生成的每一段熱路徑程式碼都可以隨手用 OpenResty XRay 的真實取樣來檢驗——對 vibe coding 產出程式碼的效能最佳化在開發階段就完成,而不是等上線後才暴露成效能債。這正是“用 AI 寫得快”和“寫出效能更優的應用”可以兼得的方式。
OpenResty XRay AI Assistant 目前處於 Beta 階段,非常歡迎大家向我們反饋實際使用中的診斷體驗與希望支援的更多資料場景。
如果您還沒有安裝 OpenResty XRay,歡迎申請免費試用,在您的實際環境裡完整體驗一遍本文展示的最佳化流程。
常見問題
AI Assistant Skill 需要甚麼前提條件?
目標機器上必須已經安裝並執行 OpenResty XRay 的 Agent 守護程序,並且您使用的 AI coding agent 支援 MCP 協議(如 Claude Code、Codex、Cursor)。Skill 本身不採集任何資料——它讀取的是 OpenResty XRay 透過非侵入式動態追蹤採集的執行時取樣。目標應用無需修改程式碼、無需重啟。
它和 OpenResty XRay 控制檯裡的 AI 助手是甚麼關係?
同一個 AI Assistant 能力的兩個出口。控制檯 AI 助手內建在網頁控制檯中,適合看報告時直接提問;AI Assistant Skill 接入您的 coding agent,讓分析資料和原始碼出現在同一個上下文裡,適合完成“解讀 → 改程式碼 → 回歸驗證”的完整迴圈。兩者目前都處於 Beta 階段。
AI 會不會未經授權就在我的機器上跑分析任務?
不會。建立分析任務屬於會改變 OpenResty XRay 狀態的操作,需要經過明確的確認門控。只有讀取已有報告、對照程式碼和繼續追問可以在對話中直接進行。
它和把火焰圖截圖貼給 ChatGPT 有甚麼區別?
通用聊天機器人只能看到您貼上的圖片或文字,結論本質上是對程式碼的猜測。AI Assistant Skill 直接讀取 OpenResty XRay 採集的取樣級資料:實際程序、樣本數量、原始檔、行號和跨層呼叫鏈都在證據鏈裡,結論可以回到原始報告逐條核對。
AI coding agent 能準確分析火焰圖嗎?
能——前提是分析建立在真實取樣資料而不是一張截圖之上。透過 OpenResty XRay AI Assistant Skill,coding agent 依據的是 OpenResty XRay 實際採集到的樣本:它知道剖析的是哪個 worker、取樣跑了多久、每個熱點棧幀對應到哪一行原始碼,因此每個結論都能回到原始報告交叉核對。它給出的仍是有證據支撐的推斷而非絕對真理——業務決策仍由工程師把關。
如何最佳化 vibe coding(AI 生成)程式碼的效能?
如果應用執行的機器上已經部署了 OpenResty XRay,就把生成這些程式碼的 coding agent 透過 AI Assistant Skill 接到 OpenResty XRay 的真實執行時取樣上。AI 生成的程式碼常常功能正確、測試能過,跑起來卻悄悄變慢——重複序列化、重複掃描這類反模式會在不知不覺中累積。讓 agent 在開發階段就讀取真實火焰圖資料,它就能在上線前攔住自己欠下的效能債。注意 Skill 不是獨立工具:沒有 OpenResty XRay Agent 在目標機器上採集資料,它就無從讀取。
關於 OpenResty XRay
OpenResty XRay 是一款動態追蹤產品,它可以自動分析執行中的應用,以解決效能問題、行為問題和安全漏洞,並提供可行的建議。在底層實現上,OpenResty XRay 由我們的 Y 語言驅動,可以在不同環境下支援多種不同的執行時,如 Stap+、eBPF+、GDB 和 ODB。
關於作者
章亦春是開源 OpenResty® 專案創始人兼 OpenResty Inc. 公司 CEO 和創始人。
章亦春(Github ID: agentzh),生於中國江蘇,現定居美國灣區。他是中國早期開源技術和文化的倡導者和領軍人物,曾供職於多家國際知名的高科技企業,如 Cloudflare、雅虎、阿里巴巴, 是 “邊緣計算“、”動態追蹤 “和 “機器程式設計 “的先驅,擁有超過 22 年的程式設計及 16 年的開源經驗。作為擁有超過 4000 萬全球域名使用者的開源專案的領導者。他基於其 OpenResty® 開源專案打造的高科技企業 OpenResty Inc. 位於美國矽谷中心。其主打的兩個產品 OpenResty XRay(利用動態追蹤技術的非侵入式的故障剖析和排除工具)和 OpenResty Edge(最適合微服務和分散式流量的全能型閘道器軟體),廣受全球眾多上市及大型企業青睞。在 OpenResty 以外,章亦春為多個開源專案貢獻了累計超過百萬行程式碼,其中包括,Linux 核心、Nginx、LuaJIT、GDB、SystemTap、LLVM、Perl 等,並編寫過 60 多個開源軟體庫。
關注我們
如果您喜歡本文,歡迎關注我們 OpenResty Inc. 公司的部落格網站 。也歡迎掃碼關注我們的微信公眾號:
翻譯
我們提供了英文版原文和中譯版(本文)。我們也歡迎讀者提供其他語言的翻譯版本,只要是全文翻譯不帶省略,我們都將會考慮採用,非常感謝!
相關文章
OpenResty XRay Jul 14, 2026

OpenResty XRay Sep 21, 2023

OpenResty XRay Jul 28, 2023

OpenResty XRay Jul 19, 2023

OpenResty XRay Jul 15, 2023