フレームグラフのAI分析から検証済みの修正へ:OpenResty XRay と Coding Agent で回すパフォーマンス最適化ループ

パフォーマンス最適化で求められることは、昔から明快です——複雑な CPU サンプリングデータから、明確な診断結論と検証可能な修正案を導き出すこと。 OpenResty XRay AI Assistant Skill を使えば、Claude Code、Codex、Cursor といった AI coding agent が OpenResty XRay と直接連携し、対象プロセスの自動特定、アナライザの起動、実際のランタイムサンプリングに基づくフレームグラフのAI分析、そしてホットスポットから具体的なソースファイルと行番号への精確な対応付けまでを行います。
対象マシンにすでに OpenResty XRay を導入しているチームにとって、この組み合わせの真価は、coding agent に欠けていたランタイムのコンテキストを補うことにあります。AI はもはや静的なコードへの漠然とした推測に頼らず、動的トレーシングで収集した実際のサンプリングに基づいてボトルネックを特定し、リファクタリングを提案します。本記事では、本番に近い Checkout エッジサービスを例に、coding agent が OpenResty XRay の実データに駆動され、三回の小さなリファクタリングを重ねて、スループットを約 336 RPS から 3 万 RPS 近くまで引き上げる様子を示します。
coding agent に足りないのは知性ではなく、ランタイムの可視性
Claude Code、Codex、Cursor といった coding agent は、コードの読解とリファクタリングにすでに非常に長けています。しかし「このサービスのパフォーマンスを最適化して」と頼むと、その視野は静的なソースファイルの中に閉じ込められます。一般的な経験則からホットスポットの位置を推測することしかできず、その推測はたいてい、大勢に影響しないマイクロ最適化に終わります。
この盲点は、vibe coding のシナリオでさらに拡大します。アプリケーションのコードの大半を coding agent が直接生成し、開発者は主に要件の記述と結果の確認を担うようになると、本記事で後ほど示す「重複シリアライズ」「重複スキャン」のようなパフォーマンスのアンチパターンは、高速な生成を繰り返すなかで静かに積み重なりがちです。コードは機能的には正しく、テストも通るのに、動かしてみると本来あるべき性能水準を大きく下回る——しかも、そのコードを生成した agent 自身はそれに気づきようがありません。
自らの手でパフォーマンス問題を追ったことのあるエンジニアには、もう半分の悩みもおなじみでしょう。CPU フレームグラフを手に入れるのは数秒で済むことが多く、本当に時間を食うのは、図を得たあとの分析と検証です。
- このホットスポットは、どの業務コードに対応するのか?
- 業務ロジックの書き方に問題があるのか、LuaJIT が JIT コンパイルに失敗しているのか、C ライブラリのオーバーヘッドなのか、それとも単なるネットワーク I/O なのか?
- 次のステップでは、OpenResty XRay の Lua アナライザとネイティブ C アナライザのどちらを起動すべきか?
- コードを修正したあと、ホットスポットが本当に消えた——別の場所へ移っただけではない——ことを、どうすれば素早く証明できるのか?
従来のトラブルシューティングでは、エンジニアはターミナル、監視プラットフォーム、アナライザの画面、コードエディタの間を行き来し、フレームグラフ上のスタックフレームとエディタ上のコードを、頭のなかで一行ずつ突き合わせる必要がありました。
OpenResty XRay AI Assistant Skill は、この分断された二つの世界をつなぎます。実際のサンプリングデータが Skill を通じて coding agent のコンテキストへ流れ込み、「フレームグラフの解釈 → コードの修正 → リグレッション検証」が一つのターミナルセッションのなかに収まります。それぞれの役割は明確です。
[ 対象マシン ]
  └─ OpenResty XRay Agent:非侵入型の動的トレーシングによるサンプリング
        │  実際のサンプリングレポート / フレームグラフ
        ▼
[ OpenResty XRay AI Assistant Skill ](MCP のブリッジ)
        │  構造化スタック + ソース行番号の対応付け
        ▼
[ coding agent ](Claude Code / Codex / Cursor)
  └─ ホットスポットの解読 → 最小限の修正案の提示 → 同一負荷での再計測・検証
[ エンジニア ]
  └─ 課題設定、業務仕様の確認、状態変更操作の承認
OpenResty XRay AI Assistant Skill とは
弊社は今年 7 月、OpenResty XRay コンソールに組み込まれた AI アシスタント(ベータ版)を公開しました——Web 画面上でレポートやフレームグラフを直接解読できるようにするものです。今回の OpenResty XRay AI Assistant Skill は、同じ機能のもう一つの窓口です。日々コードを書く際に使う coding agent へ、その機能を組み込みます。コンソールの AI アシスタントは「Web でレポートを見ながら手早く尋ねる」のに向き、Skill は「エディタとターミナルのなかで最適化ループ全体を完結させる」のに向いています——分析データとソースコードが、ついに同じコンテキストに並ぶのです。
前提:対象マシンに OpenResty XRay Agent が導入済みであること
まず本記事の適用範囲を明確にしておきます。OpenResty XRay AI Assistant Skill は単独のツールではなく、OpenResty XRay への接続方法の一つです。 その価値はすべて、OpenResty XRay が対象アプリケーションに対して行う非侵入型の動的トレーシングの上に成り立っています——対象アプリケーションはコード変更も再起動も不要ですが、データを収集する OpenResty XRay Agent デーモンは、あらかじめ対象マシンに導入しておく必要があります。Agent がバックグラウンドで収集していなければ、Skill が読み取れるデータは何もなく、分析ジョブを作成することもできません。
言い換えれば、本記事が想定する読者は「マシンにはすでに OpenResty XRay があり、エディタにはすでに coding agent がある」開発者です。まだ OpenResty XRay をお使いでない場合は、まず試用を申請し、Agent の導入を終えてから本記事の手順を実際に試してみてください。
自然言語による診断ゴールの記述
Skill を導入すれば、coding agent との対話をそのまま OpenResty XRay の実際のデータに基づいて進められます。エンジニアが課題を設定します。
OpenResty XRay Agent 973 を確認し、現在の Checkout Edge の OpenResty ワーカー、負荷、利用可能なアナライザを確認する。

同じ wrk 負荷の下で、いま確認したワーカーに対して短時間の lj-lua-on-cpu を実行し、最もホットなソースコードの呼び出しチェーンを特定する。

いま完了したレポートを読み、ホットスポットを audit.lua に対応付け、前提を一つだけ変える最小限の修正案を提示する。
coding agent は Skill を通じて、これらの要求を OpenResty XRay 向けの診断アクションへと変換し、結果を返す際には完全なコンテキストをエビデンスとして保持します。
- 実際の対象マシンと PID/プロセス
- ワーカー/マスタープロセスの関係
- アナライザ名
- サンプル数とサンプリング時間
- ソースファイル、行番号、完全な呼び出しチェーン
- LuaJIT、OpenResty、C ライブラリなど、レイヤーをまたいだスタック情報
状態変更時の確認:制御権はエンジニアの手に
分析ジョブの作成のように、OpenResty XRay の状態を変更する操作については、システムが対話型の確認を表示します。Skill はジョブを送信する前に、次のような確認リクエストを返します。
Confirmation required before changing XRay state.

Create a new jobs resource.

choices: approve | reject
エンジニアが明示的に approve と返答して初めて、coding agent はジョブの送信へ進みます。reject と返答すれば、その操作は拒否されます。つまり coding agent は、承認なしに独断で分析ジョブを開始することはありません。一方、レポートの読み取り、コードとの突き合わせ、追加の質問は、いずれも同じ対話のコンテキストのなかで連続して行えます。
デモ事例:本番に近い Checkout エッジサービス
このワークフローを示すため、実際のプロジェクトに近い Checkout Edge サービスを構築し、そのなかに実システムでよく見られる数種類のパフォーマンスのアンチパターンをあえて仕込みました(後ほど一つずつ明らかにします)。単純な Lua ハンドラが一つあるだけではなく、典型的なエッジ業務の複数ステージを含んでいます。
リクエスト
 ├─ context.lua   リクエスト・テナント・アカウント・フィーチャーフラグの抽出
 ├─ catalog.lua   商品検索、見積もり、割引、レコメンド項目
 ├─ risk.lua      User-Agent のリスクルールとリスク判定
 ├─ audit.lua     監査イベントの構築と JSON シリアライズ
 └─ app.lua       リクエストフローのオーケストレーションとレスポンス出力
ディレクトリ構成は次のとおりです。
demo/
├── nginx.conf
└── lua/
    ├── app.lua
    └── lib/
        ├── audit.lua
        ├── catalog.lua
        ├── context.lua
        └── risk.lua
再現しやすいよう、この例ではローカルの商品カタログとメモリ上のルールデータを用い、外部データベースには依存していません。一方で、リクエストのオーケストレーション、監査、リスク判定、シリアライズの各経路には、本番システムに相応の複雑さを残しています。
サービスの起動と負荷試験条件の固定
demo ディレクトリに入り、OpenResty を起動します。
cd /path/to/demo
mkdir -p logs
openresty -t -p "$PWD" -c nginx.conf
openresty -p "$PWD" -c nginx.conf -g 'daemon off;'
リクエストを一つ送り、サービスが正常かどうかを確認します。
curl -s \
  'http://127.0.0.1:18080/v1/checkout/quote?tenant=acme-eu&sku=edge-cache&quantity=2'
続いて、固定した wrk コマンドでテスト負荷を発生させます。以降の各最適化ステージでは、URL、スレッド数、コネクション数をすべて同一に保ちます。
wrk -t2 -c50 -d60s --latency \
  'http://127.0.0.1:18080/v1/checkout/quote?tenant=acme-eu&sku=edge-cache&quantity=2'
補足:本記事の比較表のスループットの数値は、いずれも同一の URL・スレッド数・コネクション数による wrk 負荷試験から得たものです。オンライン分析ジョブに合わせるため、各ステージの実行時間はわずかに異なっており、データは最適化の方向性と桁レベルの傾向を示すことを目的としています。OpenResty XRay のフレームグラフのサンプリングは、確認や分析にかかる時間が wrk の比較データに影響しないよう、別途、長めの負荷を用いています。二つの実験はそれぞれ別の問いに答えます。サンプリングは「CPU がどこに費やされているか」に、負荷試験は「固定負荷の下でサービスがどう振る舞うか」に答えます。より厳密なベンチマークでは、さらに負荷試験の時間の固定、CPU のコア固定、ワーカー数の固定を行い、複数回繰り返すべきです。
ベースライン調査:coding agent が「CPU の 99.3% は監査オブジェクトの重複シリアライズ」と特定
ベースライン版のコードは、完全なリクエストコンテキスト、見積もり、リスク判定結果、デバッグトレースを一つのネストの深いオブジェクトにまとめ、複数の監査シンク(Sink)を模擬するために、それを繰り返し JSON エンコードしていました——これが、あえて仕込んだ最初のアンチパターンです。
-- ベースライン版:demo/lua/lib/audit.lua
local payload
for _ = 1, 120 do
    payload = cjson.encode(record)
end
return payload
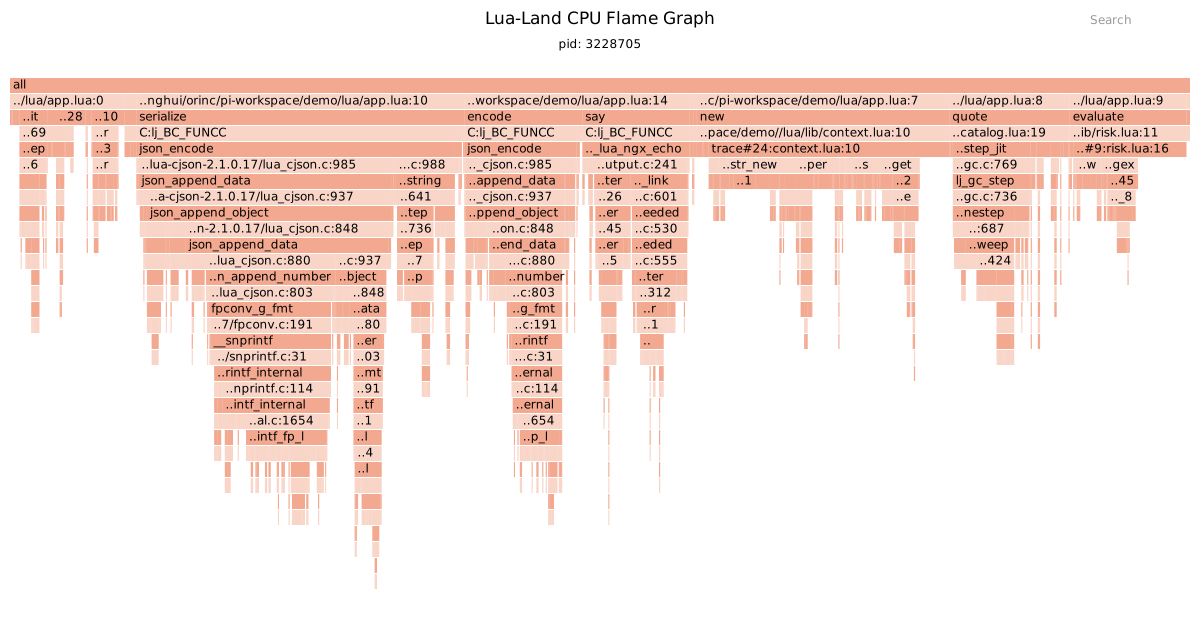
見た目には、HTTP リクエストはエラーを出さず、レスポンスも正常に返ります。調査は、先ほどの三つの自然言語による指示から始まります。エンジニアは、やみくもにコードを推測するのではなく、coding agent に実行中のワーカーを直接検査させ、approve の確認を経て lj-lua-on-cpu アナライザを起動し、Lua CPU フレームグラフを採取させます。
今回のデモで採取したベースラインのレポートは次のとおりです。
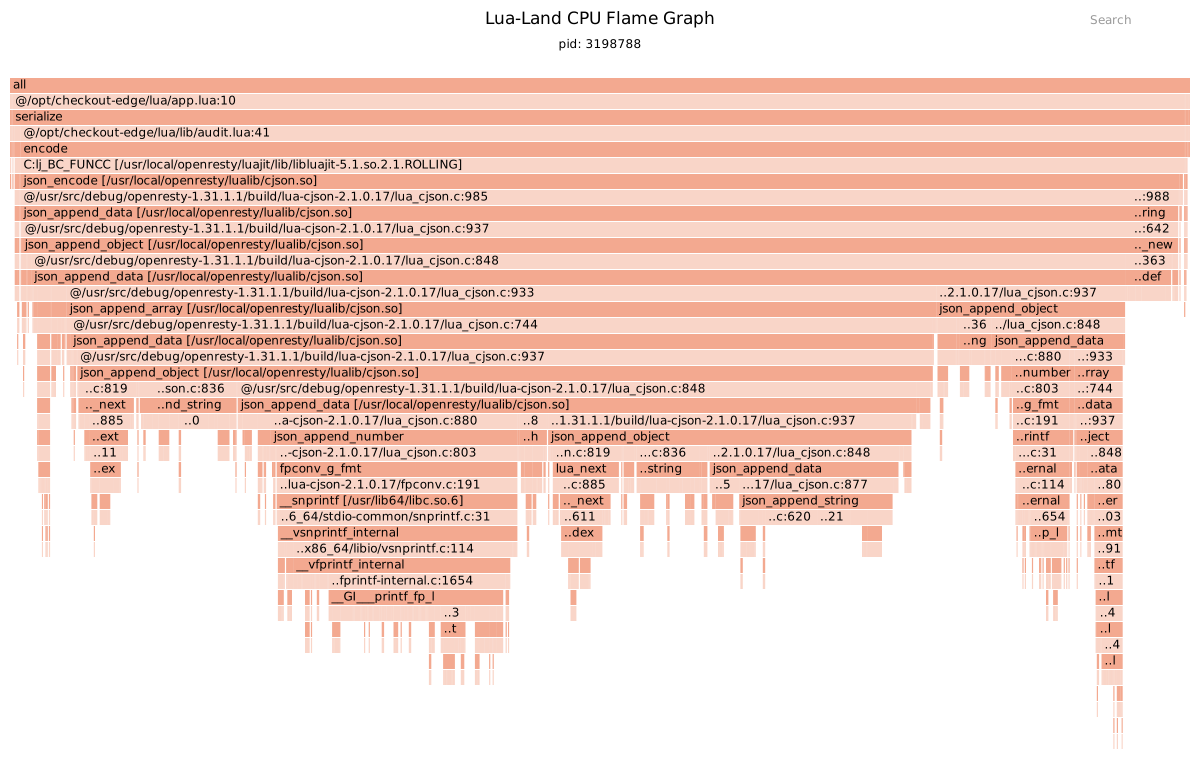
OpenResty XRay は約 3.5 秒で 1,000 個のサンプルを採取し、CPU のホットスポットは非常に集中していました。
| ホットスポット | inclusive CPU |
|---|---|
app.lua:10 から呼ばれる audit.serialize | 99.3% |
audit.lua:41 の encode | 98.6% |
cjson の json_encode | 98.2% |
lua_cjson.c:985 の JSON 走査経路 | 94.1% |
coding agent はレポートを読み取ったあと、この呼び出しチェーンを次のように再構成しました。
app.lua
  → audit.serialize
    → cjson.encode
      → cjson が監査オブジェクトと配列を再帰的に走査
そして、ホットスポットを具体的なソースファイルと行番号——audit.lua の 41 行目の encode 呼び出し——へ正確に対応付けました。コードやスクリーンショットを汎用チャットボットにそのまま投げる場合と違い、ここで coding agent が示す結論は、コードに対する静的な推測から来るものではありません。現在のワーカーの OpenResty XRay の実際のサンプリングを直接読み取ったものであり、サンプル数、プロセス、ソース行番号がいずれもエビデンスとして揃っています。
もっとも、フレームグラフは CPU サンプルがどこに集中しているかを証明できますが、監査プロトコルのどのフィールドが必須かをエンジニアに代わって決めることはできません。これが、人が責任を持って判断しなければならない最初の判断ポイントです。
第一の一手:監査データ構造のスリム化(336 → 4,457 RPS)
coding agent の提案とエンジニアによる業務仕様の確認
coding agent が、フレームグラフと audit.lua のソースを突き合わせて下した判断はこうです。監査オブジェクトが大きすぎる——完全なリクエストコンテキスト、レコメンド商品のリスト、デバッグトレースが監査ログの一件ごとに詰め込まれているが、監査の下流が本当に必要とするのは、安定した業務上の事実(リクエスト ID、テナント、ユーザー、見積もり金額、通貨、リージョン、リスク判定結果)だけである、と。
どのフィールドを削除できるかは業務仕様であり、エンジニアが確認します。確認後の最初の修正は、オブジェクトのサイズを小さくするだけにとどめ、シリアライズの回数はまだ変更しません——「一度に一つの前提だけを検証する」という原則に従います。
-- Stage 1:Allowlist DTO に変更
local record = {
    schema = "checkout.audit.v2",
    event = "quote_generated",
    request_id = context.request.id,
    tenant = context.account.tenant,
    user_id = context.account.user_id,
    region = quote.region,
    currency = quote.currency,
    total = quote.total,
    risk = {
        score = risk.score,
        decision = risk.decision,
    },
    flags = {
        checkout_v2 = context.flags.checkout_v2,
        risk_v3 = context.flags.risk_v3,
    },
    emitted_at = ngx.now(),
}
同一負荷での再計測と、coding agent による新フレームグラフの解読
監査オブジェクトは、もともとデバッグトレースを含む約 5.8 KB から、約 281 バイトへ縮小しました。同じ wrk パラメータで再度負荷試験を行うと、サービスのスループットは 336 RPS/p99 182.86 ms から一気に 4,457 RPS/p99 14.13 ms へ向上しました。
修正後、あらためて coding agent に OpenResty XRay の Lua フレームグラフを取得させます。
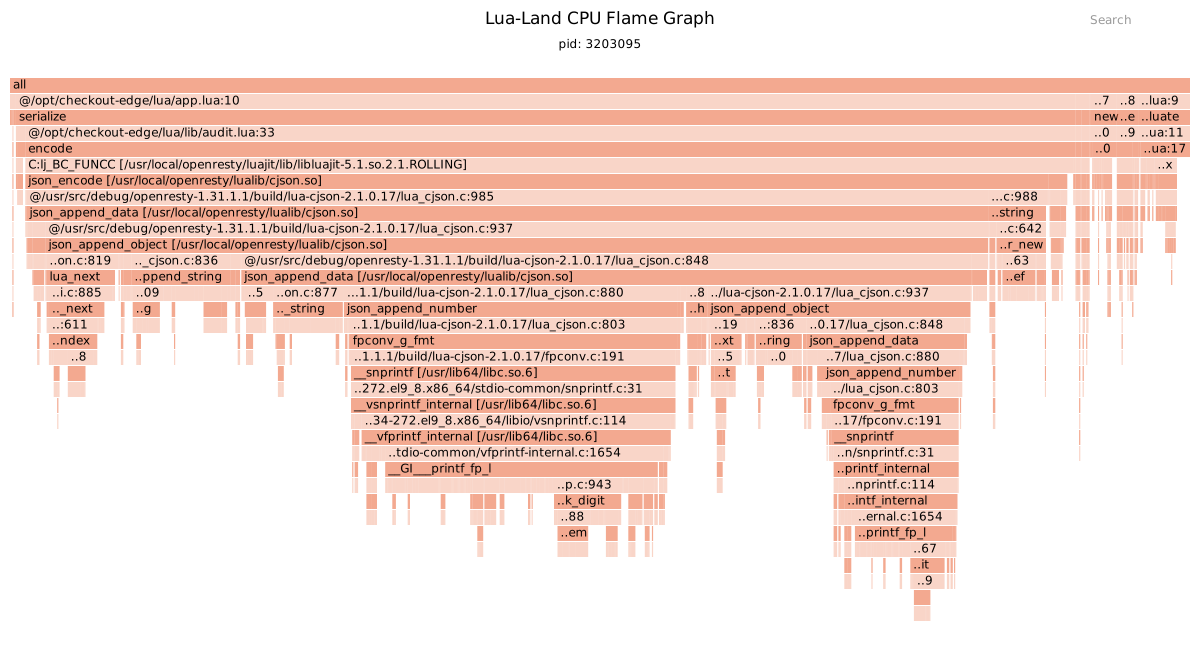
フレームグラフを見ると、serialize は依然として inclusive CPU の 89.8% を占めていますが、内部のホットスポットの内訳は変化しています。
json_append_number:28.3%fpconv_g_fmt:27.8%- libc の浮動小数点フォーマットの経路:23.1%
これを踏まえた coding agent の結論は明確です。データ構造を小さくしたことで桁違いの性能向上が得られたものの、「重複シリアライズ」は依然として構造的な無駄である——「変更が効いたか」は、明確に「次に何を変えるべきか」へと前進しました。JSON エンコードがこの種のサービスでしばしば性能ボトルネックになる理由については、以前の分析 OpenResty サービスにおける「見えないボトルネック」としての JSON をご覧ください。
第二の一手:同じデータのエンコードは一度だけ(→ 26,028 RPS)
すべての監査シンクが消費するのは同一のデータなのですから、シンクごとに Lua テーブルを走査し直す必要はまったくありません。二度目の修正では、エンコードを一度だけに絞ります。
-- Stage 2:DTO は維持し、JSON エンコードは一度だけ
function _M.serialize(context, quote, risk)
    local record = build_audit_record(context, quote, risk)
    return cjson.encode(record)
end
このステップでは JSON ライブラリを差し替えてはおらず、完全に重複した 119 回の無駄な処理を削除しただけです。
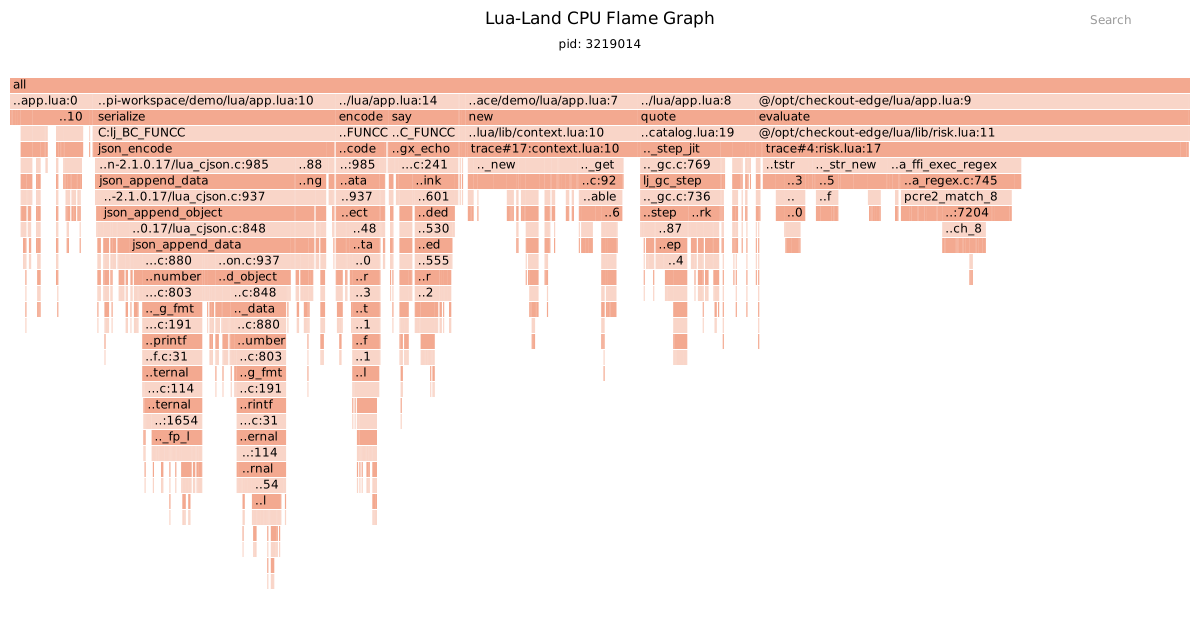
Stage 2 で再度負荷試験を行うと、スループットは 26,028 RPS/p99 13.96 ms まで一気に跳ね上がりました。ここで再び coding agent に新しい Lua フレームグラフを読み取らせると、監査シリアライズのコストはもはや画面を占有していません。
OpenResty XRay のサンプリングは、一つ下の層に隠れていた業務経路を浮かび上がらせました。
- リクエストコンテキストの生成:inclusive CPU の 14.4%
- リスク判定ルールの呼び出しチェーンが約 36.7%(inclusive) を占め、そのうち
pcre2_match_8のサブ経路が約 9.4% - 商品の見積もりと LuaJIT の GC 経路が約 6.6%
パフォーマンスチューニングでは、この現象によく出会います。二つ目のホットスポットが突然現れたのではなく、一つ目の主要なボトルネックを取り除いて初めて、二次的なボトルネックが姿を現す機会を得るのです。
Lua と C、二つの視点の切り替え:writev は幅広く見えても業務のボトルネックではない
先ほどの OpenResty XRay の Lua フレームグラフを見ると、リスク判定モジュールはさらに分析する価値がありますが、そのなかには Lua のループ、文字列処理、Nginx 正規表現の FFI、ネイティブマッチャが混在しています。coding agent は、レポートに実際に現れたネイティブ経路に基づき、視点の切り替えを提案しました。同じ Stage 2 のワーカーに対して、今度は LuaJIT に対応した OpenResty XRay の C on-CPU アナライザを起動する——固定された調査チェックリストを機械的になぞるのではなく、です。
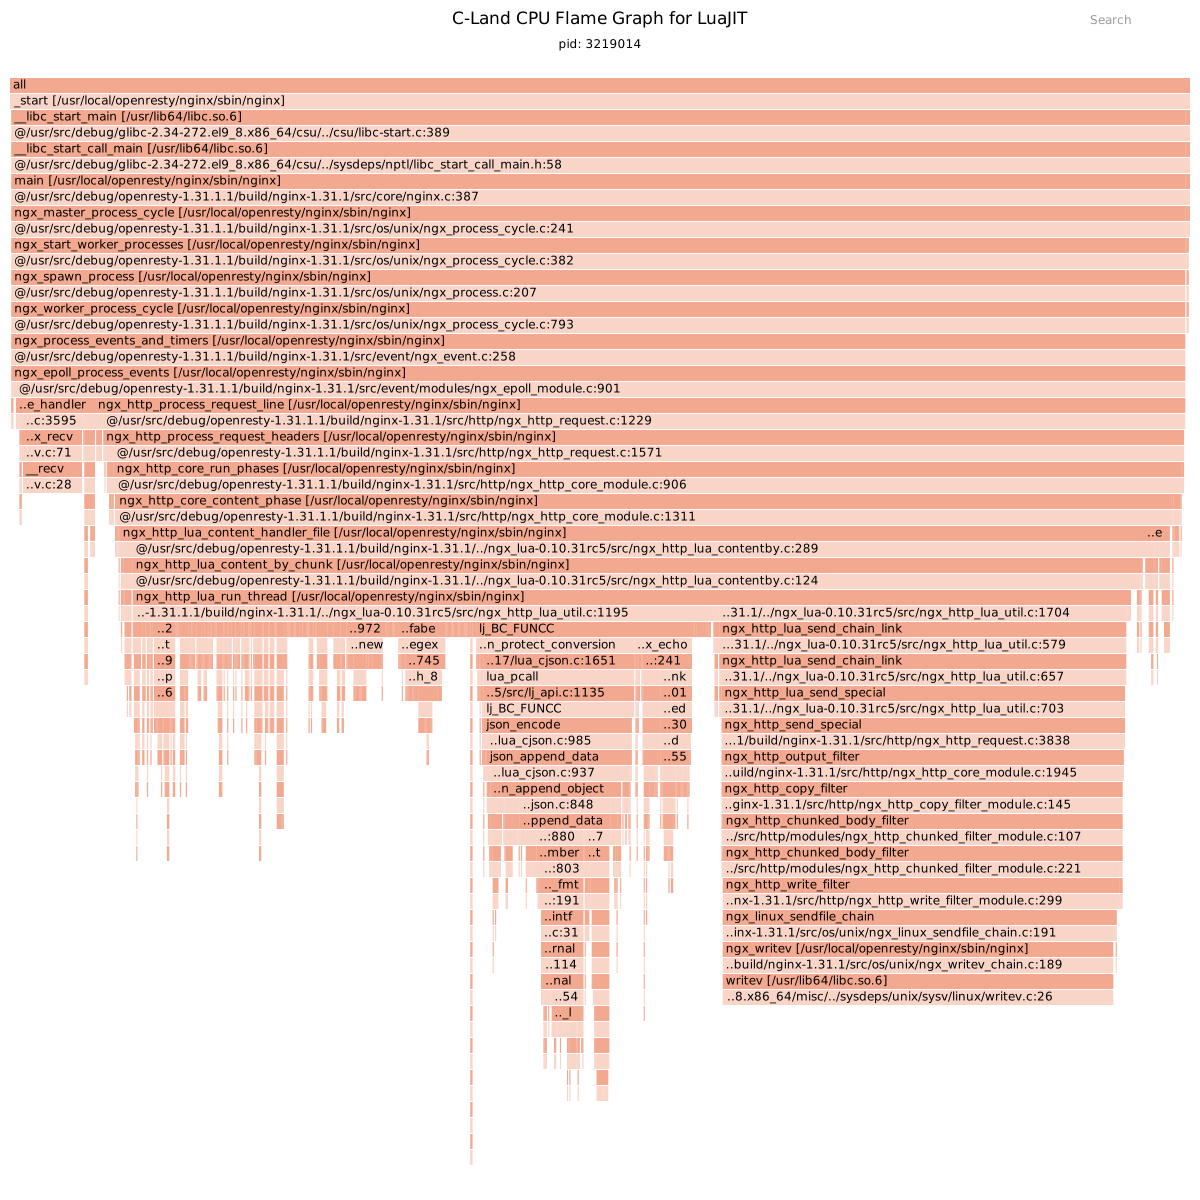
C レイヤーのフレームグラフは、レイヤーをまたいだ分析の価値を直感的に示します。
pcre2_match_8は inclusive CPU の 3.1% にすぎないwritevは 33.0%(inclusive) を占め、その self weight は 330 / 1,000 = 33.0%——分母はこのフレームグラフの total weight であり、エンドツーエンドのリクエスト数ではないjson_append_objectが約 10.4%
ここで coding agent は、重要な示唆を一つ与えます。writev は主にレスポンスデータの書き出しとネットワーク転送層のオーバーヘッドであり、Checkout のリスク判定という業務ロジックの根本原因ではない、と。C フレームグラフで幅広く見えるからといって、慌てて業務コードに手を入れるべきではありません——レスポンスのサイズ、負荷試験のクライアント、ネットワークのボトルネックは、それぞれ個別に評価すべきです。
これこそ、OpenResty XRay が Lua/C の二つの視点を組み合わせて分析することの強みです。
- Lua フレームグラフは、業務コードと呼び出しチェーンを正確に特定するのに役立ちます。
- C フレームグラフは、ネイティブの低レイヤーにおける実際の実行コストを確認するのに役立ちます。
- 二つの図を組み合わせることで、ネットワーク転送のオーバーヘッドを業務のボトルネックと誤認することも、Lua 側の重複ロジックをひとまとめに PCRE のせいにすることも、どちらも避けられます。
第三の一手:等価な 12 倍の重複スキャンを排除(→ 29,968 RPS)
coding agent がリスク判定のアンチパターンを特定
coding agent は、Lua フレームグラフのリスク判定の呼び出しチェーンをたどって risk.lua のソースを読み、ベースラインのリスク判定コードが 8 個の User-Agent パターンを 12 回にわたって重複スキャンしていることを突き止めました——これが、あえて仕込んだ二つ目のアンチパターンです。
for _ = 1, 12 do
    for i = 1, #suspicious_agents do
        local from = ngx.re.find(agent, suspicious_agents[i], "ijo")
        if from then
            score = score + 1
        end
    end
end
ここで、外側のループを単純に削除することはできません。ベースラインのロジックでは、ルールに一つ一致するごとに 12 点を積み上げているからです——リスクスコアは業務仕様の一部です。これもまた、エンジニアが責任を持って判断する判断ポイントであり、スコアリングのセマンティクスは変えてはなりません。
スコアリングのロジックを保ちつつ、スキャン回数を削減
Stage 3 の修正方針はこうです。安定した正規表現オプションをモジュールレベルに引き上げ、各ルールがリクエストごとに一度だけ実行されるようにしつつ、元どおり 12 点の重みを維持します。
-- Stage 3
local RULE_OPTIONS = "ijo"

for i = 1, #suspicious_agents do
    local pattern = suspicious_agents[i]
    local from = ngx.re.find(agent, pattern, RULE_OPTIONS)
    if from then
        -- 既存のリスクスコア仕様を維持
        score = score + 12
        hits[pattern] = true
    end
end
ここでいう「等価」には、明確な前提があります。agent、ルール配列、ルールオプションが一度のリクエストのなかで変わらないこと。ngx.re.find が、副作用を持つ関数に業務コードで差し替えられていないこと。hits[pattern] = true が冪等な書き込みであること。ループのなかに中間状態に依存する他のロジックがないこと。これらの前提のもとで初めて、ベースラインの「一致したルールごとに 1 点を加算し、12 回繰り返す」は、最終版の「一致したルールごとに 12 点を一度に加算する」と等価になります。実際のプロジェクトのリスク判定ルールがコンテキストを変更したり、カウント順序に依存したり、他の副作用を持つ場合には、この変換をそのまま適用することはできず、判定結果と reason-code についてリグレッションテストケースを追加しなければなりません。
今回の修正で実現したことは次のとおりです。
- ルールセット、マッチングオプション、リスク判定、監査結果を完全に変えないこと
- 12 倍の等価な重複スキャンを削除し、Lua の制御フロー、文字列処理、正規表現の FFI の呼び出し回数を大幅に減らしたこと
ngx.reのoオプション(once-compilation)を使い、コンパイル済みの正規表現パターンを再利用すること
もしご自身のサービスのボトルネックが本当に特定の正規表現そのものにあると疑うのであれば、Nginx 正規表現のパフォーマンス:動的トレーシングで遅いパターンを特定 の手法に従って、具体的な正規表現パターンを個別に特定できます。
修正が済んだら、coding agent に最終的な OpenResty XRay レポートを取得させます。
この時点で、アプリケーション内の CPU ホットスポットの分布はすっかり様変わりしています。
- JSON レスポンスのシリアライズ:27.8%
- リクエストコンテキストの生成:21.4%
- 商品の見積もり経路:10.2%(うち LuaJIT の GC が約 6.6%)
- リスク評価モジュールのコストは 9.9% まで低下
ここまで来ると、リスク判定の正規表現をさらに最適化しても、追加で得られる効果は大きくありません。次の最適化ラウンドを進めるのであれば、レスポンススキーマ、コンテキストオブジェクトのアロケーション、商品カタログのデータ構造を優先的に評価すべきです——そしてこの判断そのものも、依然として OpenResty XRay のサンプリングデータから導かれるものであり、coding agent がコードから当てずっぽうに思い描いたものではありません。
三段階の最適化データの比較と、手法の限界
| バージョン | 主な変更内容 | RPS | p99 レイテンシ | OpenResty XRay が観測したホットスポット |
|---|---|---|---|---|
| 複雑なベースライン | 完全な監査オブジェクト、120 回の重複エンコード | 336 | 182.86 ms | audit.serialize が 99.3% |
| Stage 1 | 監査オブジェクトを Allowlist DTO に変更 | 4,457 | 14.13 ms | serialize が 89.8% に低下、浮動小数点フォーマットが顕在化 |
| Stage 2 | 同一の DTO を JSON エンコードするのは 1 回だけ | 26,028 | 13.96 ms | コンテキスト生成・リスク判定・カタログ経路が顕在化 |
| Stage 3 | リスク判定ルールを 1 回だけ実行、正規表現のコンパイル結果を再利用 | 29,968 | 2.97 ms | リスク評価のコストが 9.9% に低下 |
繰り返しになりますが、本記事の例における負荷試験は、オンライン分析ジョブに合わせて各ステージの実行時間がわずかに異なっており、表のデータは最適化の方向性と桁レベルの傾向を示すことを目的としています。実際の本番サービスを変更する前には、時間を固定した負荷試験と完全なリグレッションテストで検証することをおすすめします。
同時に、このワークフローの限界も冷静に認識しておく必要があります。
- 業務上の判断はエンジニアが責任を持ちます。 監査フィールドを削除してよいか、リスクスコア仕様をどう定義するか——coding agent はコードとサンプリングに基づいて仮説を提示できるだけであり、最終的な確認は、依然としてエンジニアによる業務プロトコルの理解とテストによる検証に委ねられます。
- coding agent が示すのは、裏づけのある推論であって絶対の真理ではありません。 すべての最適化提案について、エンジニアは OpenResty XRay の元のレポートに立ち返って照合すべきです——OpenResty XRay AI Assistant Skill が結果を返す際に、常にレポートのリンクとサンプル数を添えるのは、まさにこのためです。
- これは、OpenResty XRay Agent がすでに導入された環境に強く依存します。 Agent がバックグラウンドでリアルタイムにデータを収集していなければ、この自動化された調査ループは動きません。
- 本記事が検証したアナライザは二つだけです。 実際に実行して検証したのは
lj-lua-on-cpuとlj-c-on-cpuです。今回の対象マシンで利用可能なアナライザ一覧には、さらに多くの方向性——Lua off-CPU(lj-lua-off-cpu)、メモリと GC に関する診断(lj-err-mem、lj-lua-newgco-size、lj-lua-tab-resize、lj-free-stats)、LuaJIT ランタイムの検査(collect-luajit-ffnames、lj-func-events、lj-jit-state)など——が並んでいますが、それらは本記事の実験で実行済みであることを意味しません。特定のアナライザが利用できるかどうかは、対象ランタイム、Agent のバージョン、OS の依存関係、権限、そして現在のプロセスが正しく検出されているかにも左右されます。また、on-CPU の結果を off-CPU、メモリ、GC の結論として扱うこともできません。 - coding agent 側で検証したのは、現時点の Skill だけです。 Claude Code、Codex、Cursor など MCP 互換クライアントの接続方法は公式ドキュメントをご覧ください。ただし本記事は、各クライアントのバージョンごとの互換性テストに代わるものではありません。加えて、短時間のサンプリング、対象のオフライン、負荷の終了、サンプル不足は、いずれもレポートが確かな結論を支えられない原因になります。
OpenResty XRay AI Assistant Skill を試す
チームが日々の開発ですでに Claude Code、Codex、Cursor など MCP 対応の AI coding agent を使っており、かつ対象マシンに OpenResty XRay が導入済みであれば、いつでも OpenResty XRay Web コンソール にログインし、MCP Server & Agent Skill の入口から接続設定とインストールガイドを入手できます。
設定が済めば、開発・テストの段階でも、本番のトラブルシューティングでも、coding agent のなかで自然言語のまま操作できます。
- 「どの OpenResty ワーカーが最も CPU を消費していますか?」
- 「Lua フレームグラフを取得して、これが本当に業務コードのホットスポットかどうか確認してください。」
- 「Lua 側のコストが目立たなければ、C アナライザでネイティブ層のコストも調べてください。」
- 「OpenResty XRay レポートのホットスポットをソースコードに直接対応付け、変更が最小でロールバックしやすい修正案を提示してください。」
vibe coding で素早くアプリケーションを構築するチームにとって、このループの意味はさらに大きくなります。デモに仕込んだ二つのアンチパターン——重複シリアライズと重複スキャン——は、まさに AI 生成コードが積み上げがちな、目に見えないパフォーマンス負債そのものです。機能的には正しく、テストも通るのに、本来の性能水準を大きく下回って動く。コードを書くのも、パフォーマンスを検証するのも同じ coding agent であれば、生成したホットパスのコードをその場で OpenResty XRay の実際のサンプリングと照らし合わせて検証できます。vibe coding で生まれたコードのパフォーマンス最適化は、リリース後に技術的負債として表面化してから始めるのではなく、開発段階で完結する——これこそ、「AI で速く書く」ことと「よりパフォーマンスの高いアプリケーションを書く」ことを両立させる方法です。
OpenResty XRay AI Assistant は現在ベータ版であり、実際の利用における診断の使い勝手や、サポートしてほしいデータのシナリオについて、皆様からのフィードバックを心より歓迎いたします。
まだ OpenResty XRay を導入していない場合は、ぜひ無料試用を申請し、ご自身の環境で本記事に示した最適化の流れを一通り体験してみてください。
よくある質問
AI Assistant Skill を使うには何が必要ですか?
対象マシンに OpenResty XRay の Agent デーモンがすでに導入され、稼働している必要があります。また、ご利用の AI coding agent が MCP プロトコルに対応している必要があります(Claude Code、Codex、Cursor など)。Skill 自体はいかなるデータも収集しません——読み取るのは、OpenResty XRay が非侵入型の動的トレーシングで収集したランタイムサンプリングです。対象アプリケーションはコード変更も再起動も不要です。
OpenResty XRay コンソールの AI アシスタントとの関係は?
同じ AI Assistant 機能の、二つの窓口です。コンソールの AI アシスタントは Web コンソールに組み込まれ、レポートを見ながら直接質問するのに向いています。AI Assistant Skill は coding agent に組み込まれ、分析データとソースコードを同じコンテキストに並べるため、「解読 → コード修正 → リグレッション検証」の一連のループを完結させるのに向いています。いずれも現在ベータ版です。
AI が無断でマシン上の分析ジョブを実行することはありますか?
ありません。分析ジョブの作成は OpenResty XRay の状態を変更する操作であり、明示的な確認ゲートを経る必要があります。対話のなかで直接行えるのは、既存レポートの読み取り、コードとの突き合わせ、追加の質問だけです。
フレームグラフのスクリーンショットを ChatGPT に貼るのと何が違いますか?
汎用チャットボットが見られるのは、貼り付けた画像やテキストだけであり、その結論は本質的にコードに対する推測です。AI Assistant Skill は、OpenResty XRay が収集したサンプリングレベルのデータを直接読み取ります。実際のプロセス、サンプル数、ソースファイル、行番号、レイヤーをまたぐ呼び出しチェーンがいずれもエビデンスとして揃っており、結論は元のレポートに立ち返って一つずつ照合できます。
AI coding agent はフレームグラフを正確に分析できますか?
できます——分析がスクリーンショットではなく、実際のサンプリングデータに根ざしている限りは。OpenResty XRay AI Assistant Skill を通じて、coding agent は OpenResty XRay が実際に収集したサンプルに基づいて動きます。どの worker をプロファイルしたか、サンプリングをどれだけ実行したか、ホットなスタックフレームがソースコードのどの行に対応するかを把握しているため、どの結論も元のレポートと突き合わせて検証できます。それでも得られるのはエビデンスに裏付けられた仮説であって、絶対的な真実ではありません——ビジネス上の判断はエンジニアが担います。
vibe coding(AI 生成)コードのパフォーマンスはどう最適化しますか?
アプリケーションが OpenResty XRay の導入済みマシンで動いているなら、そのコードを生成した coding agent を AI Assistant Skill 経由で OpenResty XRay の実際のランタイムサンプリングにつなぎます。AI 生成コードは機能的には正しく、テストも通るのに、静かに遅いことが少なくありません——重複シリアライズや重複スキャンのようなアンチパターンが、気づかないうちに積み重なるからです。開発段階で実際のフレームグラフデータを読ませれば、agent は自らが生んだパフォーマンス負債をリリース前に食い止められます。なお、Skill は単体で動くツールではありません。対象マシンで OpenResty XRay Agent がサンプルを収集していなければ、読み取るものが何もないのです。
このチュートリアル(記事)が気に入っていただけましたら、ぜひ本ブログサイトおよび弊社の YouTube チャンネルをご購読ください。ありがとうございます!
OpenResty XRay について
OpenResty XRay は動的トレーシング製品であり、実行中のアプリケーションを自動的に分析して、パフォーマンスの問題、動作の問題、セキュリティの脆弱性を解決し、実行可能な提案を提供いたします。基盤となる実装において、OpenResty XRay は弊社の Y 言語によって駆動され、Stap+、eBPF+、GDB、ODB など、様々な環境下で複数の異なるランタイムをサポートしております。
著者について
章亦春(Zhang Yichun)は、オープンソースの OpenResty® プロジェクトの創始者であり、OpenResty Inc. の CEO および創業者です。
章亦春(GitHub ID: agentzh)は中国江蘇省生まれで、現在は米国ベイエリアに在住しております。彼は中国における初期のオープンソース技術と文化の提唱者およびリーダーの一人であり、Cloudflare、Yahoo!、Alibaba など、国際的に有名なハイテク企業に勤務した経験があります。「エッジコンピューティング」、「動的トレーシング」、「機械プログラミング」 の先駆者であり、22 年以上のプログラミング経験と 16 年以上のオープンソース経験を持っております。世界中で 4000 万以上のドメイン名を持つユーザーを抱えるオープンソースプロジェクトのリーダーとして、彼は OpenResty® オープンソースプロジェクトをベースに、米国シリコンバレーの中心部にハイテク企業 OpenResty Inc. を設立いたしました。同社の主力製品である OpenResty XRay(動的トレーシング技術を利用した非侵入型の障害分析・トラブルシューティングツール)と OpenResty Edge(マイクロサービスおよび分散トラフィックに最適化された多機能ゲートウェイソフトウェア)は、世界中の多くの上場企業および大企業から高い評価を得ております。OpenResty 以外にも、章亦春は Linux カーネル、Nginx、LuaJIT、GDB、SystemTap、LLVM、Perl など、複数のオープンソースプロジェクトに累計 100 万行以上のコードを寄与し、60 以上のオープンソースソフトウェアライブラリを執筆しております。
翻訳
英語版の原文と日本語訳版(本文)をご用意しております。読者の皆様による他の言語への翻訳版も歓迎いたします。全文翻訳で省略がなければ、採用を検討させていただきます。心より感謝申し上げます!
関連記事
OpenResty XRay Jul 14, 2026

OpenResty XRay Sep 21, 2023

OpenResty XRay Jul 28, 2023

OpenResty XRay Jul 19, 2023

OpenResty XRay Jul 15, 2023