动态追踪技术漫谈
本文最初成稿于 2016 年 5 月初,后于 2020 年 2 月中进行了较大的更新和修订,后续会持续保持更新。
什么是动态追踪
我很高兴能在这里和大家分享动态追踪技术(Dynamic Tracing)这个主题,对我个人来说也是一个很激动人心的话题。那么,什么是动态追踪技术呢?
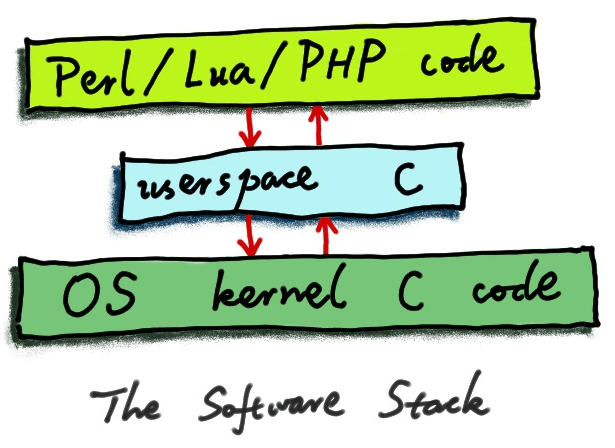
动态追踪技术其实是一种后现代的高级调试技术。它可以帮助软件工程师以非常低的成本,在非常短的时间内,回答一些很难的关于软件系统方面的问题,从而更快速地排查和解决问题。它兴起和繁荣的一个大背景是,我们正处在一个快速增长的互联网时代,作为工程师,面临着两大方面的挑战:一是规模,不管是用户规模还是机房的规模、机器的数量都处于快速增长的时代。第二方面的挑战就是复杂度。我们的业务逻辑越来越复杂,我们运行的软件系统也变得越来越复杂,我们知道它会分成很多很多层次,包括操作系统内核然后上面是各种系统软件,像数据库和 Web 服务器,再往上有脚本语言或者其他高级语言的虚拟机、解释器及即时(JIT)编译器,顶上则是应用层面的各种业务逻辑的抽象层次和很多复杂的代码逻辑。
这些巨大的挑战带来的最严重的后果就是,今天的软件工程师正在迅速地丧失对整个生产系统的洞察力和掌控力。在如此复杂和庞大的系统中,各种问题发生的概率大大提高了。有的问题可能是致命的,比如 500 错误页,还有内存泄漏,再比如说返回错误结果之类。而另一大类问题就是性能问题。我们可能会发现软件在某些时候运行的非常缓慢,或者在某些机器上运行得非常缓慢,但我们并不知道为什么。现在大家都在拥抱云计算和大数据,这种大规模的生产环境中的诡异问题只会越来越多,很容易占据工程师大部分的时间和精力。大部分问题其实是线上才有的问题,很难复现,或者几乎无法复现。而有些问题出现的比率又很小,只有百分之一、千分之一,甚至更低。我们最好能够不用摘机器下线,不用修改我们的代码或者配置,不用重启服务,在系统还在运行的时候,就把问题分析出来,定位出来,进而采取有针对性的解决办法。如果能做到这一点,那才是完美的,才能每晚都睡上一个好觉。
动态追踪技术实际就能帮助我们实现这种愿景,实现这种梦想,从而极大地解放我们工程师的生产力。我至今还记得当年在雅虎中国工作的时候,有时不得不半夜打车去公司处理线上问题。这显然是非常无奈和挫败的生活和工作方式。后来我曾在美国的一家 CDN 公司工作,当时我们的客户也会有自己的运维团队,他们没事就去翻 CDN 提供的原始日志。可能对我们来说是百分之一或者千分之一这样的问题,但是对他们来说就是比较重要的问题,就会报告上来,我们则就必须去排查,必须去找出真正的原因,反馈给他们。这些实际存在的大量的现实问题,激发着新技术的发明和产生。
我觉得动态追踪技术很了不起的一点就是,它是一种“活体分析”技术。就是说,我们的某个程序或者整个软件系统仍然在运行,仍然在线上服务,还在处理真实请求的时候,我们就可以去对它进行分析(不管它自己愿不愿意),就像查询一个数据库一样。这是非常有意思的。很多工程师容易忽略的一点是,正在运行的软件系统本身其实就包含了绝大部分的宝贵信息,就可以被直接当作是一个实时变化的数据库来进行“查询”。当然了,这种特殊的“数据库”须是只读的,否则我们的分析和调试工作就有可能会影响到系统本身的行为,就可能会危害到在线服务。我们可以在操作系统内核的帮助下,从外部发起一系列有针对性的查询,获取关于这个软件系统本身运行过程当中的许多第一手的宝贵的细节信息,从而指导我们的问题分析和性能分析等很多工作。
动态追踪技术通常是基于操作系统内核来实现的。操作系统内核其实可以控制整个软件世界,因为它其实是处于“造物主”这样的一个地位。它拥有绝对的权限,同时它可以确保我们针对软件系统发出的各种“查询”不会影响到软件系统本身的正常运行。换句话说,我们的这种查询必须是足够安全的,是可以在生产系统上大量使用的。把软件系统作为“数据库”进行查询就会涉及到一个查询方式的问题,显然我们并不是通过 SQL 这样的方式去查询这种特殊的“数据库”。
在动态追踪里面一般是通过探针这样的机制来发起查询。我们会在软件系统的某一个层次,或者某几个层次上面,安置一些探针,然后我们会自己定义这些探针所关联的处理程序。这有点像中医里面的针灸,就是说如果我们把软件系统看成是一个人,我们可以往他的一些穴位上扎一些“针”,那么这些针头上面通常会有我们自己定义的一些“传感器”,我们可以自由地采集所需要的那些穴位上的关键信息,然后把这些信息汇总起来,产生可靠的病因诊断和可行的治疗方案。这里的追踪通常涉及两个维度。一个是时间维度,因为这个软件还一直在运行,它便有一个在时间线上的连续的变化过程。另一个维度则是空间维度,因为可能它涉及到多个不同的进程,包含内核进程,而每个进程经常会有自己的内存空间、进程空间,那么在不同的层次之间,以及在同一层次的内存空间里面,我可以同时沿纵向和横向,获取很多在空间上的宝贵信息。这有点儿像蛛蛛在蛛网上搜索猎物。
我们既可以在操作系统内核里面拿一些信息,也可以在用户态程序等较高的层面上采集一些信息。这些信息可以在时间线上面关联起来,构建出一幅完整的软件图景,从而有效地指导我们做一些很复杂的分析。这里非常关键的一点是,它是非侵入式的。如果把软件系统比作一个人,那我们显然不想把一个活人开膛破肚,却只是为了帮他诊断疾病。相反,我们会去给他拍一张 X 光,给他做一个核磁共振,给他号号脉,或者最简单的,用听诊器听一听,诸如此类。针对一个生产系统的诊断,其实也应如此。动态追踪技术允许我们使用非侵入式的方式,不用去修改我们的操作系统内核,不用去修改我们的应用程序,也不用去修改我们的业务代码或者任何配置,就可以快速高效地精确获取我们想要的信息,第一手的信息,从而帮助定位我们正在排查的各种问题。
我觉得大部分工程师可能特别熟悉软件构造的过程,这其实是咱的基本功了。我们通常会建立不同的抽象层次,一层一层的把软件构造起来,无论是自底向上,还是自顶向下。建立软件抽象层次的方式很多,比如通过面向对象里面的类和方法,或者直接通过函数和子例程等方式。而调试的过程,其实与软件构造的方式刚好相反,我们恰恰是要能够很轻易地“打破”原先建立起来的这些抽象层次,能够随心所欲的拿到任意一个或者任意几个抽象层次上的任何所需的信息,而不管什么封装设计,不管什么隔离设计,不管任何软件构造时人为建立的条条框框。这是因为调试的时候总是希望能拿到尽可能多的信息,毕竟问题可能发生在任何层面上。
正因为动态追踪技术一般是基于操作系统内核的,而内核是“造物主”,是绝对的权威,所以这种技术可以轻而易举地贯通各个软件层次的抽象和封装,因此软件构造时建立的抽象和封装层次其实并不会成为阻碍。相反,在软件构造时建立起来的设计良好的抽象与封装层次,其实反而有助于调试过程,关于这点,我们后面还会专门提到。我在自己的工作当中经常会发现,有的工程师在线上出问题的时候,非常慌乱,会去胡乱猜测可能的原因,但又缺乏任何证据去支持或者否证他的猜测与假设。他甚至会在线上反复地试错,反复地折腾,搞得一团乱麻,毫无头绪,让自己和身边的同事都很痛苦,白白浪费了宝贵的排错时间。当我们有了动态追踪技术之后,排查问题本身就可能会变成一个非常有趣的过程,让我们遇到线上的诡异问题就感到兴奋,就仿佛好不容易又逮着机会,可以去解一道迷人的谜题。当然了,这一切的前提是,我们具有趁手的强大的工具,帮助我们进行信息采集和推理,帮助我们快速证明或否证任何假设和推测。
动态追踪的优点
动态追踪技术一般是不需要目标应用来配合的。比如说,我们在给一个哥们做体检的时候,他还在操场上奔跑,我们就能在他还在运动的过程中,直接给他拍一张动态的 X 光,而且他自己还不知道。仔细想一下,这其实是一件很了不起的事情。各种基于动态追踪的分析工具的运行方式都是一种“热插拔”的方式,就是说,我们随时可以运行这个工具,随时进行采样,随时结束采样,而不用管目标系统的当前状态。很多统计和分析,其实都是目标系统上线之后才想到的,我们并不可能在上线前预测未来可能会遇到哪些问题,更不可能预测我们需要采集的所有信息,用以排查那些未知的问题。动态追踪的好处就是,可以实现“随时随地,按需采集”。另外还有一个优势是它自身的性能损耗极小。仔细写出的调试工具对系统的极限性能的影响,通常在百分之五,甚至更低的比例以下,所以它一般不会对我们的最终用户产生可以观察到的性能影响。另外,即使是这么小的性能损耗也只发生在我们实际采样的那几十秒或者几分钟以内。一旦我们的调试工具结束运行,在线系统又会自动恢复到原先百分之百的性能,继续向前狂奔。

DTrace 与 SystemTap
说到动态追踪就不能不提到 DTrace。DTrace 算是现代动态追踪技术的鼻祖了,它于 21 世纪初诞生于 Solaris 操作系统,是由原来的 Sun Microsystems 公司的工程师编写的。可能很多同学都听说过 Solaris 系统和 Sun 公司的大名。
最初产生的时候,我记得有这样一个故事,当时 Solaris 操作系统的几个工程师花了几天几夜去排查一个看似非常诡异的线上问题。开始他们以为是很高级的问题,就特别卖力,结果折腾了几天,最后发现其实是一个非常愚蠢的、某个不起眼的地方的配置问题。自从那件事情之后,这些工程师就痛定思痛,创造了 DTrace 这样一个非常高级的调试工具,来帮助他们在未来的工作当中避免把过多精力花费在愚蠢问题上面。毕竟大部分所谓的“诡异问题”其实都是低级问题,属于那种“调不出来很郁闷,调出来了更郁闷”的类型。
应该说 DTrace 是一个非常通用的调试平台,它提供了一种很像 C 语言的脚本语言,叫做 D。基于 DTrace 的调试工具都是使用这种语言编写的。D 语言支持特殊的语法用以指定“探针”,这个“探针”通常有一个位置描述的信息。你可以把它定位在某个内核函数的入口或出口,抑或是某个用户态进程的 函数入口或出口,甚至是任意一条程序语句或机器指令上面。编写 D 语言的调试程序是需要对系统有一定的了解和知识的。这些调试程序是我们重拾对复杂系统的洞察力的利器。Sun 公司有一位前工程师叫做 Brendan Gregg,他是最初的 DTrace 的用户,甚至早于 DTrace 被开源出来。Brendan 编写了很多可以复用的基于 DTrace 的调试工具,一齐放在一个叫做 DTrace Toolkit 的开源项目中。Dtrace 是最早的动态追踪框架,也是最有名的一个。
DTrace 的优势是它采取了跟操作系统内核紧密集成的一种方式。D 语言的实现其实是一个虚拟机(VM),有点像 Java 虚拟机(JVM)。它的一个好处在于 D 语言的运行时是常驻内核的,而且非常小巧,所以每个调试工具的启动时间和退出时间都很短。但是我觉得 DTrace 也是有明显缺点的。其中一个让我很难受的缺点是 D 语言缺乏循环结构,这导致许多针对目标进程中的复杂数据结构的分析工具很难编写。虽然 DTrace 官方声称缺少循环的原因是为了避免过热的循环,但显然 DTrace 是可以在 VM 级别上面有效限制每一个循环的执行次数的。另外一个较大的缺点是,DTrace 对于用户态代码的追踪支持比较弱,没有自动的加载用户态调试符号的功能,需要自己在 D 语言里面声明用到的用户态 C 语言结构体之类的类型。1
DTrace 的影响是非常大的,很多工程师把它移植到其他的操作系统。比方说苹果的 Mac OS X 操作系统上就有 DTrace 的移植。其实近些年发布的每一台苹果笔记本或者台式机上面,都有现成的 dtrace 命令行工具可以调用,大家可以去在苹果机器的命令行终端上尝试一下。这是苹果系统上面的一个 DTrace 的移植。FreeBSD 操作系统也有这样一个 DTrace 的移植。只不过它并不是默认启用的。你需要通过命令去加载 FreeBSD 的 DTrace 内核模块。Oracle 也有在它自己的 Oracle Linux 操作系统发行版当中开始针对 Linux 内核进行 DTrace 移植。不过 Oracle 的移植工作好像一直没有多少起色,毕竟 Linux 内核并不是 Oracle 控制的,而 DTrace 是需要和操作系统内核紧密集成的。出于类似的原因,民间一些勇敢的工程师尝试的 DTrace 的 Linux 移植也一直距离生产级别的要求很远。
相比 Solaris 上面原生的 DTrace,这些 DTrace 移植都或多或少的缺乏某些高级特性,所以从能力上来说,还不及最本初的 DTrace。
DTrace 对 Linux 操作系统的另一个影响反映在 SystemTap 这个开源项目。这是由 Red Hat 公司的工程师创建的较为独立的动态追踪框架。SystemTap 提供了自己的一种小语言,和 D 语言并不相同。多年以后,正是这种语言碎片化促使我们创造了 Ylang——一门与 C 语言真正兼容的统一动态追踪语言。显然,Red Hat 自己服务于非常多的企业级用户,他们的工程师每天需要处理的各种线上的“诡异问题”自然也是极多的。这种技术的产生必然是现实需求激发的。我觉得 SystemTap 是目前 Linux 世界功能最强大,同时也是最实用的动态追踪框架。我在自己的工作当中已经成功使用多年。SystemTap 的作者 Frank Ch. Eigler 和 Josh Stone 等人,都是非常热情、同时非常聪明的工程师。我在 IRC 或者邮件列表里的提问,他们一般都会非常快且非常详尽地进行解答。值得一提的是,我也曾给 SystemTap 贡献过一个较为重要的新特性,使其能在任意的探针上下文中访问用户态的全局变量的取值。我当时合并到 SystemTap 主线的这个 C++ 补丁的规模达到了约一千行,多亏了 SystemTap 作者们的热心帮助2。这个新特性在我基于 SystemTap 实现的动态脚本语言(比如 Perl 和 Lua)的火焰图工具中扮演了关键角色。
SystemTap 的优点是它有非常成熟的用户态调试符号的自动加载,同时也有循环这样的语言结构可以去编写比较复杂的探针处理程序,可以支持很多很复杂的分析处理。由于 SystemTap 早些年在实现上的不成熟,导致互联网上充斥着很多针对它的已经过时了的诟病和批评。最近几年 SystemTap 已然有了长足的进步。我在 2017 年创办的 OpenResty Inc. 公司也对 SystemTap 做了非常大的增强和优化。
当然,SystemTap 也是有缺点的。首先,它并不是 Linux 内核的一部分,就是说它并没有与内核紧密集成,所以它需要一直不停地追赶主线内核的变化。另一个缺点是,它通常是把它的“小语言”脚本(有点像 D 语言哦)动态编译成一个 Linux 内核模块的 C 源码,因此经常需要在线部署 C 编译器工具链和 Linux 内核的头文件。出于这些原因,SystemTap 脚本的启动相比 DTrace 要慢得多,和 JVM 的启动时间倒有几分类似。虽然存在这些缺点3,但总的来说,SystemTap 还是一个非常成熟的动态追踪框架。
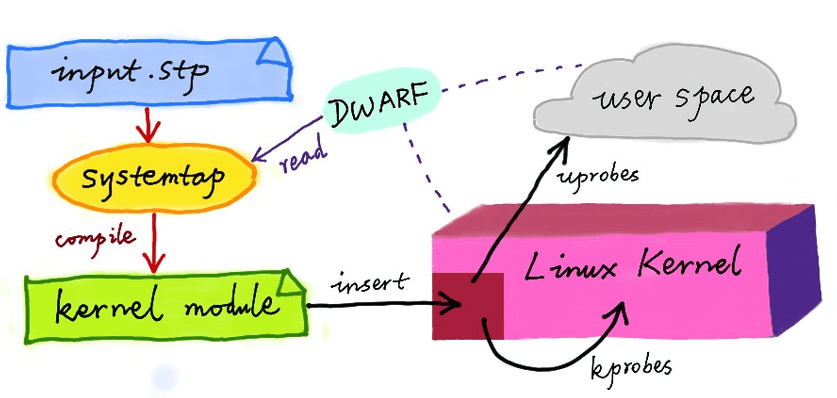
无论是 DTrace 还是 SystemTap,其实都不支持编写完整的调试工具,因为它们都缺少方便的命令行交互的原语。所以我们才看到现实世界中许多基于它们的工具,其实最外面都有一个 Perl、Python 或者 Shell 脚本编写的包裹。为了便于使用一种干净的语言编写完整的调试工具,我曾经给 SystemTap 语言进行了扩展,实现了一个更高层的“宏语言”,叫做 stap++4。我自己用 Perl 实现的 stap++ 解释器可以直接解释执行 stap++ 源码,并在内部调用 SystemTap 命令行工具。有兴趣的朋友可以查看我开源在 GitHub 上面的 stapxx 这个代码仓库。这个仓库里面也包含了很多直接使用我的 stap++ 宏语言实现的完整的调试工具。
SystemTap 在生产上的应用
DTrace 有今天这么大的影响离不开著名的 DTrace 布道士 Brendan Gregg 老师。前面我们也提到了他的名字。他最初是在 Sun Microsystems 公司,工作在 Solaris 的文件系统优化团队,是最早的 DTrace 用户。他写过好几本有关 DTrace 和性能优化方面的书,也写过很多动态追踪方面的博客文章。
2011 年我离开淘宝以后,曾经在福州过了一年所谓的“田园生活”。在田园生活的最后几个月当中,我通过 Brendan 的公开博客较为系统地学习了 DTrace 和动态追踪技术。其实最早听说 DTrace 是因为一位微博好友的评论,他只提到了 DTrace 这个名字。于是我便想了解一下这究竟是什么东西。谁知,不了解不知道,一了解吓一跳。这竟然是一个全新的世界,彻底改变了我对整个计算世界的看法。于是我就花了非常多的时间,一篇一篇地仔细精读 Brendan 的个人博客。后来终于有一天,我有了一种大彻大悟的感觉,终于可以融会贯通,掌握到了动态追踪技术的精妙。
2012 年我结束了在福州的“田园生活”,来到美国加入前面提到的那家 CDN 公司。然后我就立即开始着手把 SystemTap 以及我已领悟到的动态追踪的一整套方法,应用到这家 CDN 公司的全球网络当中去,用于解决那些非常诡异非常奇怪的线上问题。我在这家公司观察到其实很多工程师在排查线上问题的时候,经常会自己在软件系统里面埋点。这主要是在业务代码里,乃至于像 Nginx 这样的系统软件的代码基(code base)里,自己去做修改,添加一些计数器,或者去埋下一些记录日志的点。通过这种方式,大量的日志会在线上被实时地采集起来,进入专门的数据库,然后再进行离线分析。显然这种做法的成本是巨大的,不仅涉及业务系统本身的修改和维护成本的陡然提高,而且全量采集和存储大量的埋点信息的在线开销,也是非常可观的。而且经常出现的情况是,张三今天在业务代码里面埋了一个采集点,李四明天又埋下另一个相似的点,事后可能这些点又都被遗忘在了代码基里面,而没有人再去理会。最后这种点会越来越多,把代码基搞得越来越凌乱。这种侵入式的修改,会导致相应的软件,无论是系统软件还是业务代码,变得越来越难以维护。
埋点的方式主要存在两大问题,一个是“太多”的问题,一个是“太少”的问题。“太多”是指我们往往会采集一些根本不需要的信息,只是一时贪多贪全,从而造成不必要的采集和存储开销。很多时候我们通过采样就能进行分析的问题,可能会习惯性的进行全网全量的采集,这种代价累积起来显然是非常昂贵的。那“太少”的问题是指,我们往往很难在一开始就规划好所需的所有信息采集点,毕竟没有人是先知,可以预知未来需要排查的问题。所以当我们遇到新问题时,现有的采集点搜集到的信息几乎总是不够用的。这就导致频繁地修改软件系统,频繁地进行上线操作,大大增加了开发工程师和运维工程师的工作量,同时增加了线上发生更大故障的风险。
另外一种暴力调试的做法也是我们某些运维工程师经常采用的,即把机器拉下线,然后设置一系列临时的防火墙规则,以屏蔽用户流量或者自己的监控流量,然后在生产机上各种折腾。这是很繁琐影响很大的过程。首先它会让机器不能再继续服务,降低了整个在线系统的总的吞吐能力。同时有些只有真实流量才能复现的问题,此时再也无法复现了。可以想象这些粗暴的做法有多么让人头疼。
实际上运用 SystemTap 动态追踪技术可以很好地解决这样的问题,有“润物细无声”之妙。首先我们不需要去修改我们的软件栈(software stack)本身,不管是系统软件还是业务软件。我经常会编写一些有针对性的工具,然后在一些关键的系统「穴位」上面放置一些经过仔细安排的探针。这些探针会采集各自的信息,同时调试工具会把这些信息汇总起来输出到终端。用这种方式我可以在某一台机器或某几台机器上面,通过采样的方式,很快地得到我想要的关键信息,从而快速地回答一些非常基本的问题,给后续的调试工作指明方向。
正如我前面提到的,与其在生产系统里面人工去埋点去记日志,再搜集日志入库,还不如把整个生产系统本身看成是一个可以直接查询的“数据库”,我们直接从这个“数据库”里安全快捷地得到我们想要的信息,而且绝不留痕迹,绝不去采集我们不需要的信息。利用这种思想,我编写了很多调试工具,绝大部分已经开源在了 GitHub 上面,很多是针对像 Nginx、LuaJIT 和操作系统内核这样的系统软件,也有一些是针对更高层面的像 OpenResty 这样的 Web 框架。有兴趣的朋友可以查看 GitHub 上面的 nginx-systemtap-toolkit、perl-systemtap-toolkit 和 stappxx 这几个代码仓库。
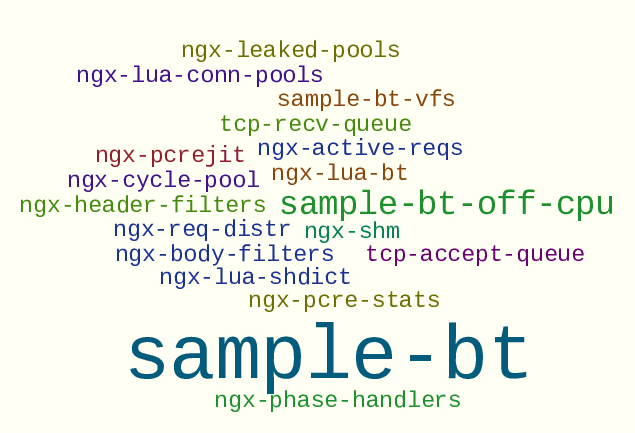
利用这些工具,我成功地定位了数不清的线上问题,有些问题甚至是我意外发现的。下面就随便举几个例子吧。
第一个例子是,我使用基于 SystemTap 的火焰图工具分析我们线上的 Nginx 进程,结果发现有相当一部分 CPU 时间花费在了一条非常奇怪的代码路径上面。这其实是我一位同事在很久之前调试一个老问题时遗留下来的临时的调试代码,有点儿像我们前面提到的“埋点代码”。结果它就这样被遗忘在了线上,遗忘在了公司代码仓库里,虽然当时那个问题其实早已解决。由于这个代价高昂的“埋点代码”一直没有去除,所以一直都产生着较大的性能损耗,而一直都没有人注意到。所以可谓是我意外的发现。当时我就是通过采样的方式,让工具自动绘制出一张火焰图。我一看这张图就可以发现问题并能采取措施。这是非常非常有效的方式。
第二个例子是,很少量的请求存在延时较长的问题,即所谓的“长尾请求”。这些请求数目很低,但可能达到「秒级」这样的延时。当时有同事乱猜说是我的 OpenResty 有 bug,我不服气,于是立即编写了一个 SystemTap 工具去在线进行采样,对那些超过一秒总延时的请求进行分析。该工具会直接测试这些问题请求内部的时间分布,包括请求处理过程中各个典型 I/O 操作的延时以及纯 CPU 计算延时。结果很快定位到是 OpenResty 在访问 Go 编写的 DNS 服务器时,出现延时缓慢。然后我再让我的工具输出这些长尾 DNS 查询的具体内容,发现都是涉及 CNAME 展开。显然,这与OpenResty 无关了,而进一步的排查和优化也有了明确的方向。
第三个例子是,我们曾注意到某一个机房的机器存在比例明显高于其他机房的网络超时的问题,但也只有 1% 的比例。一开始我们很自然的去怀疑网络协议栈方面的细节。但后来我通过一系列专门的 SystemTap 工具直接分析那些超时请求的内部细节,便定位到了是硬盘 配置方面的问题。从网络到硬盘,这种调试是非常有趣的。第一手的数据让我们快速走上正确的轨道。
还有一个例子是,我们曾经通过火焰图在 Nginx 进程里观察到文件的打开和关闭操作占用了较多的 CPU 时间,于是我们很自然地启用了 Nginx 自身的文件句柄缓存配置,但是优化效果并不明显。于是再做出一张新的火焰图,便发现因为这回轮到 Nginx 的文件句柄缓存的元数据所使用的“自旋锁”占用很多 CPU 时间了。这是因为我们虽然启用了缓存,但把缓存的大小设置得过大,所以导致元数据的自旋锁的开销抵消掉了缓存带来的好处。这一切都能在火焰图上面一目了然地看出来。假设我们没有火焰图,而只是盲目地试验,很可能会得出 Nginx 的文件句柄缓存没用的错误结论,而不会去想到去调整缓存的参数。
最后一个例子是,我们在某一次上线操作之后,在线上最新的火焰图中观察到正则表达式的编译操作占用了很多 CPU 时间,但其实我们已经在线上启用了正则编译结果的缓存。很显然,我们业务系统中用到的正则表达式的数量,已然超出了我们最初设置的缓存大小,于是很自然地想到把线上的正则缓存调的更大一些。然后,我们在线上的火焰图中便再看不到正则编译操作了。
通过这些例子我们其实可以看到,不同的数据中心,不同的机器,乃至同一台机器的不同时段,都会产生自己特有的一些新问题。我们需要的是直接对问题本身进行分析,进行采样,而不是胡乱去猜测去试错。有了强大的工具,排错其实是一个事半功倍的事情。
自从我们成立了 OpenResty Inc. 公司以后,我们研发了 OpenResty XRay 这一款全新一代的动态追踪平台。我们已经不再手动去使用 SystemTap 这样的开源解决方案了。
火焰图
前面我们已经多次提到了火焰图(Flame Graph)这种东西,那么火焰图是什么呢?它其实是一个非常了不起的可视化方法,是由前面已经反复提到的 Brendan Gregg 同学发明的。
火焰图就像是给一个软件系统拍的 X 光照片,可以很自然地把时间和空间两个维度上的信息融合在一张图上,以非常直观的形式展现出来,从而反映系统在性能方面的很多定量的统计规律。
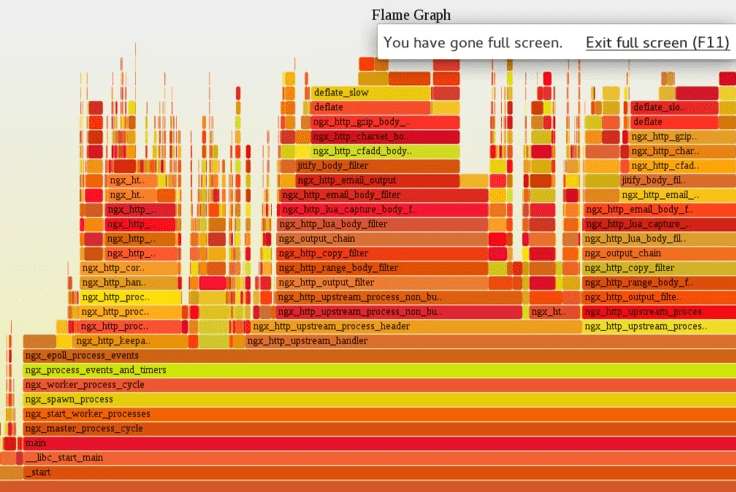
比方说,最经典的火焰图是统计某一个软件的所有代码路径在 CPU 上面的时间分布。通过这张分布图我们就可以直观地看出哪些代码路径花费的 CPU 时间较多,而哪些则是无关紧要的。进一步地,我们可以在不同的软件层面上生成火焰图,比如说可以在系统软件的 C/C++ 语言层面上画出一张图,然后再在更高的——比如说——动态脚本语言的层面,例如 Lua 和 Perl 代码的层面,画出火焰图。不同层面的火焰图常常会提供不同的视角,从而反映出不同层面上的代码热点。
因为我自己维护着 OpenResty 这样的开源软件的社区,我们有自己的邮件列表,我经常会鼓励报告问题的用户主动提供自己绘制的火焰图,这样我们就可以惬意地看图说话,帮助用户快速地进行性能问题的定位,而不至于反复地试错,和用户一起去胡乱猜测,从而节约彼此大量的时间,皆大欢喜。
这里值得注意的是,即使是遇到我们并不了解的陌生程序,通过看火焰图,也可以大致推出性能问题的所在,即使从未阅读过它的一行源码。这是一件非常了不起的事情。因为大部分程序其实是编写良好的,也就是说它往往在软件构造的时候就使用了抽象层次,比如通过函数。这些函数的名称通常会包含语义上的信息,并在火焰图上面直接显示出来。通过这些函数名,我们可以大致推测出对应的函数,乃至对应的某一条代码路径,大致是做什么事情的,从而推断出这个程序所存在的性能问题。所以,又回到那句老话,程序代码中的命名非常重要,不仅有助于阅读源码,也有助于调试问题。而反过来,火焰图也为我们提供了一条学习陌生的软件系统的捷径。毕竟重要的代码路径,几乎总是花费时间较多的那些,所以值得我们重点研究;否则的话,这个软件的构造方式必然存在很大的问题。
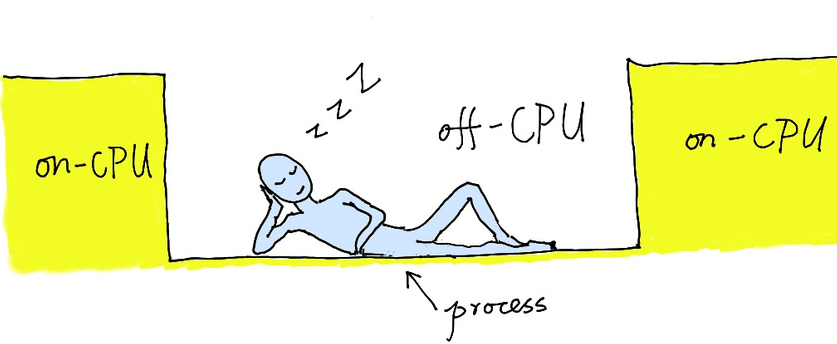
火焰图其实可以拓展到其他维度,比如刚才我们讲的火焰图是看程序运行在 CPU 上的时间在所有代码路径上的分布,这是 on-CPU 时间这个维度。类似地,某一个进程不运行在任何 CPU 上的时间其实也是非常有趣的,我们称之为 off-CPU 时间。off-CPU 时间一般是这个进程因为某种原因处于休眠状态,比如说在等待某一个系统级别的锁,或者被一个非常繁忙的进程调度器(scheduler)强行剥夺 CPU 时间片。这些情况都会导致这个进程无法运行在 CPU 上,但是仍然花费很多的挂钟时间。通过这个维度的火焰图我们可以得到另一幅很不一样的图景。通过这个维度上的信息,我们可以分析系统锁方面的开销(比如 sem_wait 这样的系统调用),某些阻塞的 I/O 操作(例如 open、read 之类),还可以分析进程或线程之间争用 CPU 的问题。通过 off-CPU 火焰图,都一目了然。
应该说 off-CPU 火焰图也算是我自己的一个大胆尝试。记得最初我在加州和内华达州之间的一个叫做 Tahoe 的湖泊边,阅读 Brendan 关于 off-CPU 时间的一篇博客文章。我当然就想到,或许可以把 off-CPU 时间代替 on-CPU 时间应用到火焰图这种展现方式上去。于是回来后我就在公司的生产系统中做了这样一个尝试,使用 SystemTap 绘制出了 Nginx 进程的 off-CPU 火焰图。我在推特上公布了这个成功尝试之后,Brendan 还专门联系到我,说他自己之前也尝试过这种方式,但效果并不理想。我估计这是因为他当时将之应用于多线程的程序,比如 MySQL,而多线程的程序因为线程同步方面的原因,off-CPU 图上会有很多噪音,容易掩盖真正有趣的那些部分。而我应用 off-CPU 火焰图的场景是像 Nginx 这样的单线程程序,所以 off-CPU 火焰图里往往会立即指示出那些阻塞 Nginx 事件循环的系统调用,抑或是 sem_wait 之类的锁操作,又或者是抢占式的进程调度器的强行介入,于是可以非常好地帮助分析一大类的性能问题。在这样的 off-CPU 火焰图中,唯一的“噪音”其实就是 Nginx 事件循环本身的 epoll_wait 这样的系统调用,很容易识别并忽略掉。
类似地,我们可以把火焰图拓展到其他的系统指标维度,比如内存泄漏的字节数。有一回我就使用“内存泄漏火焰图”快速定位了 Nginx 核心中的一处很微妙的泄漏问题。由于该泄漏发生在 Nginx 自己的内存池中,所以使用 Valgrind 和 AddressSanitizer 这样的传统工具是无法捕捉到的。还有一次也是使用“内存泄漏火焰图”轻松定位了一位欧洲开发者自己编写的 Nginx C 模块中的泄漏。那处泄漏非常细微和缓慢,困挠了他很久,而我帮他定位前都不需要阅读他的源代码。细想起来我自己都会觉得有些神奇。当然,我们也可以将火焰图拓展到文件 I/O 的延时和数据量等其他系统指标。所以这真是一种了不起的可视化方法,可以用于很多完全不同的问题类别。
我们的 OpenResty XRay 产品支持自动采样各种类型的火焰图,包括 C/C++ 级别火焰图、Lua 级别火焰图、off-CPU 和 on-CPU 火焰图、内存动态分配火焰图、内存对象引用关系火焰图、文件 IO 火焰图、等等。
方法论
前面我们介绍到火焰图这样的基于采样的可视化方法,它其实算是非常通用的方法了。不管是什么系统,是用什么语言编写的,我们一般都可以得到一张某种性能维度上的火焰图,然后轻松进行分析。但更多的时候,我们可能需要对一些更深层次的更特殊的问题进行分析和排查,此时就需要编写一系列专门化的动态追踪工具,有计划有步骤地去逼近真正的问题。
在这个过程当中,我们推荐的策略是一种所谓的小步推进、连续求问的方式。也就是说我们并不指望一下编写一个很庞大很复杂的调试工具,一下子采集到所有可能需要的信息,从而一下子解决掉最终的问题。相反,我们会把最终问题的假设,分解成一系列的小假设,然后逐步求索,逐步验证,不断确定会修正我们的方向,不断地调整我们的轨迹和我们的假设,以接近最终的问题。这样做有一个好处是,每一个步骤每一个阶段的工具都可以足够的简单,那么这些工具本身犯错的可能性就大大降低。Brendan 也注意到他如果尝试编写多用途的复杂工具,这种复杂工具本身引入 bug 的可能性也大大提高了。而错误的工具会给出错误的信息,从而误导我们得出错误的结论。这是非常危险的。简单工具的另一大好处是,在采样过程当中对生产系统产生的开销也会相对较小,毕竟引入的探针数目较少,每个探针的处理程序也不会有太多太复杂的计算。这里的每一个调试工具都有自己的针对性,都可以单独使用,那么这些工具在未来得到复用的机会也大大提高。所以总的来说,这种调试策略是非常有益的。
值得一提的是,这里我们拒绝所谓的“大数据”的调试做法。即我们并不会去尝试一下子采集尽可能全的信息和数据。相反,我们在每一个阶段每一个步骤上只采集我们当前步骤真正需要的信息。在每一步上,基于我们已经采集到的信息,去支持或者修正我们原来的方案和原来的方向,然后去指导编写下一步更细化的分析工具。
另外,对于非常小频率发生的线上事件,我们通常会采用“守株待兔”的做法,也就是说我们会设一个阈值或其他筛选条件,坐等有趣的事件被我们的探针捕获到。比如在追踪小频率的大延时请求的时候,我们会在调试工具里,首先筛选出那些延时超过一定阈值的请求,然后针对这些请求,采集尽可能多的实际需要的细节信息。这种策略其实跟我们传统的尽可能多的采集全量统计数据的做法完全相反,正因为我们是有针对性地、有具体策略地进行采样分析,我们才能把损耗和开销降到最低点,避免无谓的资源浪费。
我们的 OpenResty XRay 产品通过知识库和推理引擎,可以自动化应用各种动态追踪方面的方法论,可以自动使用系统性的方法,逐步缩小问题范围,直至定位问题根源,再报告给用户,并向用户建议优化或修复方法。
知识就是力量
我觉得动态追踪技术很好地诠释了一句老话,那就是“知识就是力量”。
通过动态追踪工具,我们可以把我们原先对系统的一些认识和知识,转变成可以解决实际问题的非常实用的工具。我们原先在计算机专业教育当中,通过课本了解到的那些原本抽象的概念,比如说虚拟文件系统、虚拟内存系统、进程调度器等等,现在都可以变得非常鲜活和具体。我们第一次可以在实际的生产系统当中,真切地观察它们具体的运作,它们的统计规律,而不用把操作系统内核或者系统软件的源码改得面目全非。这些非侵入式的实时观测的能力,都得益于动态追踪技术。
这项技术就像是金庸小说里杨过使的那把玄铁重剑,完全不懂武功的人自然是使不动的。但只要会一些武功,就可以越使越好,不断进步,直至木剑也能横行天下的境界。所以但凡你有一些系统方面的知识,就可以把这把“剑”挥动起来,就可以解决一些虽然基本但原先都无法想象的问题。而且你积累的系统方面的知识越多,这把“剑”就可以使得越好。而且,还有一点很有意思的是,你每多知道一点,就立马能多解决一些新的问题。反过来,由于我们可以通过这些调试工具解决很多问题,可以测量和学习到生产系统里面很多有趣的微观或宏观方面的统计规律,这些看得见的成果也会成为我们学习更多的系统知识的强大动力。于是很自然地,这也就成为有追求的工程师的“练级神器”。
记得我在微博上面曾经说过,“鼓励工程师不断的深入学习的工具才是有前途的好工具”。这其实是一个良性的相互促进的过程。
开源与调试符号
前面我们提到,动态追踪技术可以把正在运行的软件系统变成一个可以查询的实时只读数据库,但是做到这一点通常是有条件的,那就是这个软件系统得有比较完整的调试符号。那么调试符号是什么呢?调试符号一般是软件在编译的时候,由编译器生成的供调试使用的元信息。这些信息可以把编译后的二进制程序里面的很多细节信息,比如说函数和变量的地址、数据结构的内存布局等等,映射回源代码里面的那些抽象实体的名称,比如说函数名、变量名、类型名之类。Linux 世界常见的调试符号的格式称为 DWARF(与英文单词“矮人”相同)。正是因为有了这些调试符号,我们在冰冷黑暗的二进制世界里面才有了一张地图,才有了一座灯塔,才可能去解释和还原这个底层世界里每一个细微方面的语义,重建出高层次的抽象概念和关系。
通常也只有开源软件才容易生成调试符号,因为绝大多数闭源软件出于保密方面的原因,并不会提供任何调试符号,以增加逆向工程和破解的难度。其中有一个例子是 Intel 公司的 IPP 这个程序库。IPP 针对 Intel 的芯片提供了很多常见算法的优化实现。我们也曾经尝试过在生产系统上面去使用基于 IPP 的 gzip 压缩库,但不幸的是我们遇到了问题—— IPP 会时不时的在线上崩溃。显然,没有调试符号的闭源软件在调试的时候会非常痛苦。我们曾经跟 Intel 的工程师远程沟通了好多次都没有办法定位和解决问题,最后只好放弃。如果有源代码,或者有调试符号,那么这个调试过程很可能会变的简单许多。
关于开源与动态追踪技术之间这种水乳相容的关系,Brendan Gregg 在他之前的一次分享当中也有提及。特别是当我们的整个软件栈(software stack)都是开源的时候,动态追踪的威力才有可能得到最大限度的发挥。软件栈通常包括操作系统内核、各种系统软件以及更上层的高级语言程序。当整个栈全部开源的时候,我们就可以轻而易举的从各个软件层面得到想要的信息,并将之转化为知识,转化为行动方案。
由于较复杂的动态追踪都会依赖于调试符号,而有些 C 编译器生成的调试符号是有问题的。这些含有错误的调试信息会导致动态追踪的效果打上很大的折扣,甚至直接阻碍我们的分析。比方说使用非常广泛的 GCC 这个 C 编译器,在 4.5 这个版本之前生成的调试符号质量是很差的,而 4.5 之后则有了长足的进步,尤其是在开启编译器优化的情况下。
我们的 OpenResty XRay 动态追踪平台会实时抓取公网上常见的开源软件的调试符号包和二进制包,并进行分析和索引。目前这个数据库已经索引了几十 TB 的数据了。
2026 年更新: 上文中“几十 TB”的数字是本文最初撰写时的数据。截至 2026 年,OpenResty XRay 软件包数据库的规模已达到 PB 级别,并仍在持续增长。
Linux 内核的支持
前面提到,动态追踪技术一般是基于操作系统内核的,而对于我们平时使用非常广泛的 Linux 操作系统内核来说,其动态追踪的支持之路是一个漫长而艰辛的过程。其中一个主要原因或许是因为 Linux 的老大 Linus 一直觉得这种技术没有必要。
最初 Red Hat 公司的工程师为 Linux 内核准备了一个所谓的 utrace 的补丁,用来支持用户态的动态追踪技术。这是 SystemTap 这样的框架最初仰赖的基础。在漫长的岁月里,Red Hat 家族的 Linux 发行版都默认包含了这个 utrace 补丁,比如 RHEL、CentOS 和 Fedora 之类。在那段 utrace 主导的日子里,SystemTap 只在 Red Hat 系的操作系统中有意义。这个 utrace 补丁最终也未能合并到主线版本的 Linux 内核中,它被另一种折衷的方案所取代。
Linux 主线版本很早就拥有了 kprobes 这种机制,可以动态地在指定的内核函数的入口和出口等位置上放置探针,并定义自己的探针处理程序。
用户态的动态追踪支持姗姗来迟,经历了无数次的讨论和反复修改。从官方 Linux 内核的 3.5 这个版本开始,引入了基于 inode 的 uprobes 内核机制,可以安全地在用户态函数的入口等位置设置动态探针,并执行自己的探针处理程序。再后来,从 3.10 的内核开始,又融合了所谓的 uretprobes 这个机制5,可以进一步地在用户态函数的返回地址上设置动态探针。uprobes 和 uretprobes 加在一起,终于可以取代 utrace 的主要功能。utrace 补丁从此也完成了它的历史使命。而 SystemTap 现在也能在较新的内核上面,自动使用 uprobes 和 uretprobes 这些机制,而不再依赖于 utrace 补丁。
最近几年 Linux 的主线开发者们,把原来用于防火墙的 netfilter 里所使用的动态编译器,即 BPF,扩展了一下,得到了一个所谓的 eBPF,可以作为某种更加通用的内核虚拟机。通过这种机制,我们其实可以在 Linux 中构建类似 DTrace 那种常驻内核的动态追踪虚拟机。而事实上,最近已经有了一些这方面的尝试,比如说像 BPF 编译器(BCC)这样的工具,使用 LLVM 工具链来把 C 代码编译为 eBPF 虚拟机所接受的字节码。总的来说,Linux 的动态追踪支持是变得越来越好的。特别是从 3.15 版本的内核开始,动态追踪相关的内核机制终于变得比较健壮和稳定了。可惜的是,eBPF 在设计上一直有严重的限制,使得那些基于 eBPF 开发的动态追踪工具始终停留在较为简单的水平上,用我的话来说,还停留在“石器时代”。虽然 SystemTap 最近也开始支持 eBPF 这个运行时,但这个运行时支持的 stap 语言特性也是极为有限的,即使 SystemTap 的老大 Frank 也表达了这方面的担心。
硬件追踪
我们看到动态追踪技术在软件系统的分析当中可以扮演非常关键的角色,那么很自然地会想到,是否也可以用类似的方法和思想去追踪硬件。
我们知道其实操作系统是直接和硬件打交道的,那么通过追踪操作系统的某些驱动程序或者其他方面,我们也可以间接地去分析与之相接的硬件设备的一些行为和问题。同时,现代硬件,比如说像 Intel 的 CPU,一般会内置一些性能统计方面的寄存器(Hardware Performance Counter),通过软件读取这些特殊寄存器里的信息,我们也可以得到很多有趣的直接关于硬件的信息。比如说 Linux 世界里的 perf 工具最初就是为了这个目的。甚至包括 VMWare 这样的虚拟机软件也会去模拟这样特殊的硬件寄存器。基于这种特殊寄存器,也产生了像 Mozilla rr 这样有趣的调试工具,可以高效地进行进程执行过程的录制与回放。
直接对硬件内部设置动态探针并实施动态追踪,或许目前还存在于科幻层面,欢迎有兴趣的同学能够贡献更多的灵感和信息。
死亡进程的遗骸分析
我们前面看到的其实都是对活着的进程进行分析,或者说正在运行的程序。那么死的进程呢?对于死掉的进程,其实最常见的形式就是进程发生了异常崩溃,产生了所谓的 core dump 文件。其实对于这样死掉的进程剩下的“遗骸”,我们也可以进行很多深入的分析,从而有可能确定它的死亡原因。从这个意义上来讲,我们作为程序员扮演着「法医」这样的角色。
最经典的针对死进程遗骸进行分析的工具便是鼎鼎大名的 GNU Debugger(GDB)。那么 LLVM 世界也有一个类似的工具叫做 LLDB。显然,GDB 原生的命令语言是非常有局限的,我们如果手工逐条命令地对 core dump 进行分析其实能得到地信息也非常有限。其实大部分工程师分析 core dump 也只是用 bt full 命令查看一下当前的 C 调用栈轨迹,抑或是利用 info reg 命令查看一下各个 CPU 寄存器的当前取值,又或者查看一下崩溃位置的机器代码序列,等等。而其实更多的信息深藏于在堆(heap)中分配的各种复杂的二进制数据结构之中。对堆里的复杂数据结构进行扫描和分析,显然需要自动化,我们需要一种可编程的方式来编写复杂的 core dump 的分析工具。
顺应此需求,GDB 在较新的版本当中(我记得好像是从 7.0 开始的),内置了对 Python 脚本的支持。我们现在可以用 Python 来实现较复杂的 GDB 命令,从而对 core dump 这样的东西进行深度分析。事实上我也用 Python 写了很多这样的基于 GDB 的高级调试工具,甚至很多工具是和分析活体进程的 SystemTap 工具一一对应起来的。与动态追踪类似,借助于调试符号,我们可以在黑暗的“死亡世界”中找到光明之路。
不过这种做法带来的一个问题是,工具的开发和移植变成了一个很大的负担。用 Python 这样的脚本语言来对 C 风格的数据结构进行遍历并不是一件有趣的事情。这种奇怪的 Python 代码写多了真的会让人抓狂。另外,同一个工具,我们既要用 SystemTap 的脚本语言写一遍,然后又要用 GDB 的 Python 代码来写一遍:无疑这是一个很大的负担,两种实现都需要仔细地进行开发和测试。它们虽然做的是类似的事情,但实现代码和相应的 API 都完全不同(这里值得一提的是,LLVM 世界的 LLDB 工具也提供了类似的 Python 编程支持,而那里的 Python API 又和 GDB 的不相兼容)。
我们当然也可以用 GDB 对活体程序进行分析,但和 SystemTap 相比,GDB 最明显的就是性能问题。我曾经比较过一个较复杂工具的 SystemTap 版和 GDB Python 版。它们的性能相差有一个数量级。GDB 显然不是为这种在线分析来设计的,相反,更多地考虑了交互性的使用方式。虽然它也能以批处理的方式运行,但是内部的实现方式决定了它存在非常严重的性能方面的限制。其中最让我抓狂的莫过于 GDB 内部滥用 longjmp 来做常规的错误处理,从而带来了严重的性能损耗,这在 SystemTap 生成的 GDB 火焰图上是非常明显的。幸运地是,对死进程的分析总是可以离线进行,我们没必要在线去做这样的事情,所以时间上的考虑倒并不是那么重要了。然而不幸的是,我们的一些很复杂的 GDB Python 工具,需要运行好几分钟,即使是离线来做,也是让人感到很挫败的。
我自己曾经使用 SystemTap 对 GDB + Python 进行性能分析,并根据火焰图定位到了 GDB 内部最大的两处执行热点。然后,我给 GDB 官方提了两个 C 补丁,一是针对 Python 字符串操作,一是针对 GDB 的错误处理方式。它们使得我们最复杂的 GDB Python 工具的整体运行速度提高了 100%。GDB 官方目前已经合并了其中一个补丁。使用动态追踪技术来分析和改进传统的调试工具,也是非常有趣的。
我已经把很多从前在自己的工作当中编写的 GDB Python 的调试工具开源到了 GitHub 上面,有兴趣的同学可以去看一下。一般是放在 nginx-gdb-utils 这样的 GitHub 仓库里面,主要针对 Nginx 和 LuaJIT。我曾经利用这些工具协助 LuaJIT 的作者 Mike Pall 定位到了十多个 LuaJIT 内部的 bug。这些 bug 大多隐藏多年,都是 Just-in-Time (JIT) 编译器中的很微妙的问题。
由于死掉的进程不存在随时间变化的可能性,我们姑且把这种针对 core dump 的分析称之为“静态追踪”吧。
我们的 OpenResty XRay 产品通过 Y 语言 编译器,可以让各种用 Y 语言编写的分析工具也能同时支持 GDB 这样的平台,从而自动化对 core dump 文件的深入分析。
传统的调试技术
说到 GDB,我们就不得不说一说动态追踪与传统的调试方法之间的区别与联系。细心的有经验的工程师应该会发现,其实动态追踪的“前身”就是在 GDB 里面设置断点,然后在断点处进行一系列检查的这种方式。只不过不同的是,动态追踪总是强调非交互式的批处理,强调尽可能低的性能损耗。而 GDB 这样的工具天然就是为交互操作而生的,所以实现并不考虑生产安全性,也不怎么在乎性能损耗。一般它的性能损耗是极大的。同时 GDB 所基于的 ptrace 这种很古老的系统调用,其中的坑和问题也非常多。比如 ptrace 需要改变目标调试进程的父亲,还不允许多个调试者同时分析同一个进程。所以,从某种意义上来讲,使用 GDB 可以模拟一种所谓的“穷人的动态追踪”。
很多编程初学者喜欢使用 GDB 进行“单步执行”,而在真实的工业界的生产开发当中,这种方式经常是非常缺乏效率的。这是因为单步执行的时候往往会产生程序执行时序上的变化,导致很多与时序相关的问题无法再复现。另外,对于复杂的软件系统,单步执行很容易让人迷失在纷繁的代码路径当中,或者说迷失在所谓的“花园小径”当中,只见树木,不见森林。
所以,对于日常的开发过程当中的调试,其实我们还是推荐最简单也是看起来最笨的方法,即在关键代码路径上打印输出语句。这样我们通过查看日志等输出得到一个有很完整的上下文,从而能够有效进行分析的程序执行结果。当这种做法与测试驱动的开发方式结合起来的时候,尤为高效。显然,这种加日志和埋点的方式对于在线调试是不切合实际的,关于这一点,前面已经充分地讨论了。而另一方面,传统的性能分析工具,像 Perl 的 DProf、C 世界里的 gprof、以及其他语言和环境的性能分析器(profiler),往往需要用特殊的选项重新编译程序,或者以特殊的方式重新运行程序。这种需要特别处理和配合的性能分析工具,显然并不适用在线的实时活体分析。
凌乱的调试世界
当今的调试世界是很凌乱的,正如我们前面看到的有 DTrace、SystemTap、eBPF/BCC、GDB、LLDB 这些,还有很多很多我们没有提到的,大家都可以在网络上查到。或许这从一个侧面反映出了我们所处的这个真实世界的混乱。
之前有很多年我都在想,我们可以设计并实现一种大一统的调试语言。后来我在 OpenResty Inc. 公司终于实现了这样的一种语言,叫做 Y 语言。它的编译器能够自动生成各种不同的调试框架和技术所接受的输入代码。比如说生成 DTrace 接受的 D 语言代码,生成 SystemTap 接受的 stap 脚本,还有 GDB 接受的 Python 脚本,以及 LLDB 的另一种不兼容 API 的 Python 脚本,抑或是 eBPF 接受的字节码,乃至 BCC 接受的某种 C 和 Python 代码的混合物。
如果我们设计的一个调试工具需要移植到多个不同的调试框架,那么显然人工移植的工作量是非常大的,正如我前面所提到的。而如果有这样一个大一统的 Y 语言,其编译器能够自动把同一份 Y 代码转换为针对各种不同调试平台的输入代码,并针对那些平台进行自动优化,那么每一种调试工具我们就只需要用 Y 语言写一遍就可以了。这将是巨大的解脱。而作为调试者本人,也没有必要亲自去学习所有那些具体的调试技术的凌乱的细节,亲自去踩每一种调试技术的“坑”。
Y 语言目前已经作为 OpenResty XRay 产品的一部分,提供给广大用户。
有朋友可能要问为什么要叫做 Y 呢? 这是因为我的名字叫亦春,而亦字的汉语拼音的第一个字母就是 Y……当然了,还有更重要的原因,那就是它是用来回答以「为什么」开头的问题的语言,而「为什么」在英语里面就是「why」,而 why 与 Y 谐音。
OpenResty XRay
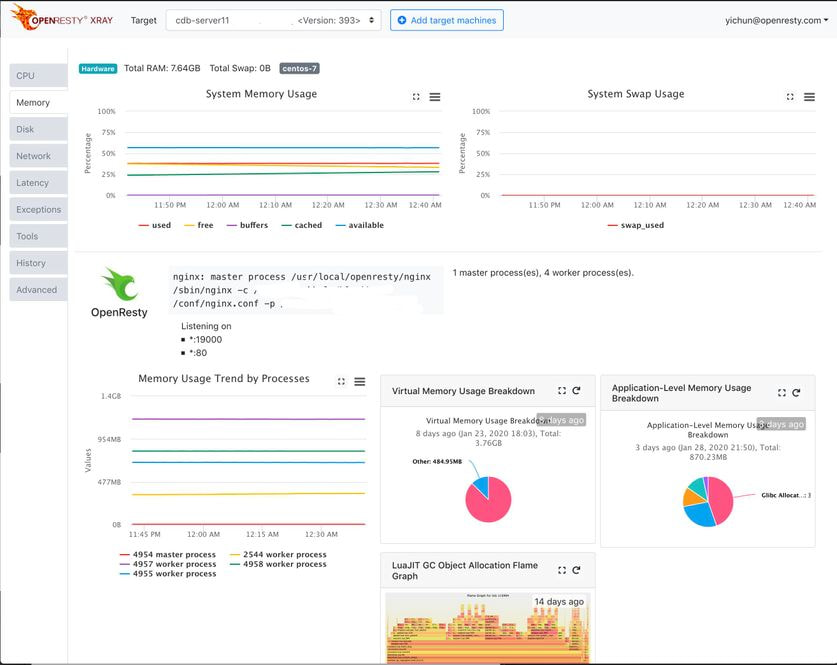
OpenResty XRay 是由 OpenResty Inc. 公司提供的商业产品。OpenResty XRay 可以在无需目标程序任何配合的情况下,帮助用户深入洞察其线上或者线下的各种软件系统的行为细节,有效地分析和定位各种性能问题、可靠性问题和安全问题。在技术上,它拥有比 SystemTap 更强的追踪功能,同时在性能上和易用性上也比 SystemTap 提高很多。它同时也可以支持自动分析 core dump 文件这样的程序遗骸。这项技术如今支撑的完整产品形态——对线上系统 CPU、内存、IO 问题的自动分析——见《OpenResty XRay 是什么》。
有兴趣的朋友欢迎联系我们,申请免费试用。
了解更多
如果你还想了解更多关于动态追踪的技术、工具、方法论和案例,可以关注我们 OpenResty Inc. 公司的博客网站 。也欢迎扫码关注我们的微信公众号:
同时非常欢迎大家试用我们的 OpenResty XRay 商业产品。
动态追踪方面的先驱,Brendan Gregg 老师的博客也有很多精采内容。
鸣谢
本文得到了我的很多朋友和家人的帮助。首先要感谢师蕊辛苦的听写笔录工作;本文其实源自一次长达一小时的语音分享。然后要感谢很多朋友认真的审稿和意见反馈。同时也感谢我的父亲和妻子在文字上的耐心帮助。
关于作者
章亦春是开源 OpenResty® 项目创始人兼 OpenResty Inc. 公司 CEO 和创始人。
章亦春(Github ID: agentzh),生于中国江苏,现定居美国湾区。他是中国早期开源技术和文化的倡导者和领军人物,曾供职于多家国际知名的高科技企业,如 Cloudflare、雅虎、阿里巴巴, 是 “边缘计算“、”动态追踪 “和 “机器编程 “的先驱,拥有超过 22 年的编程及 16 年的开源经验。作为拥有超过 4000 万全球域名用户的开源项目的领导者。他基于其 OpenResty® 开源项目打造的高科技企业 OpenResty Inc. 位于美国硅谷中心。其主打的两个产品 OpenResty XRay(利用动态追踪技术的非侵入式的故障剖析和排除工具)和 OpenResty Edge(最适合微服务和分布式流量的全能型网关软件),广受全球众多上市及大型企业青睐。在 OpenResty 以外,章亦春为多个开源项目贡献了累计超过百万行代码,其中包括,Linux 内核、Nginx、LuaJIT、GDB、SystemTap、LLVM、Perl 等,并编写过 60 多个开源软件库。
译文
我们提供了英译版和中文原文(本文) 。我们欢迎读者提供其他语言的翻译版本,只要是全文翻译不带省略,我们都将会考虑采用,非常感谢!
SystemTap 和 OpenResty XRay 都没有这些限制和缺点。 ↩︎
在我成立 OpenResty Inc. 公司之后,我们团队也给开源 SystemTap 项目贡献过数量众多的补丁,从新功能到 bug 修复。 ↩︎
OpenResty XRay 的动态追踪平台并不存在 SystemTap 的这些缺点。 ↩︎
stap++ 项目不再继续维护,已被使用全新一代动态追踪技术的 OpenResty XRay 平台和工具集所取代。 ↩︎
uretprobes 其实在实现上有很大的问题,因为它会直接修改目标程序的系统运行时栈,从而会破坏很多重要的功能,比如 stack unwinding。我们的 OpenResty XRay 自己重新实现了类似 uretprobes 的效果,但却没有它的这些缺点。 ↩︎
相关文章
OpenResty XRay Mar 3, 2026

OpenResty XRay Sep 24, 2025

OpenResty XRay Jul 1, 2025

OpenResty XRay Jun 27, 2025

OpenResty XRay Jun 27, 2025